Thiết kế Mint.com
Lưu ý: Tài liệu này liên kết trực tiếp tới các mục liên quan trong các chủ đề system design để tránh lặp nội dung. Xem phần được liên kết để biết các ý thảo luận chung, đánh đổi và phương án thay thế.
Bước 1: Xác định use case và ràng buộc
Thu thập yêu cầu và giới hạn phạm vi bài toán. Đặt câu hỏi để làm rõ use case và ràng buộc. Thảo luận các giả định.
Vì không có người phỏng vấn để hỏi lại, chúng ta tự định nghĩa một số use case và ràng buộc.
Use case
Chúng ta giới hạn bài toán ở các use case sau
- User kết nối với một tài khoản tài chính
- Service trích xuất giao dịch từ tài khoản
- Cập nhật hằng ngày
- Phân loại giao dịch
- Cho phép user tự ghi đè danh mục
- Không tự động phân loại lại
- Phân tích chi tiêu hằng tháng theo danh mục
- Service đề xuất ngân sách
- Cho phép user tự đặt ngân sách
- Gửi thông báo khi sắp chạm hoặc vượt ngân sách
- Service có tính sẵn sàng cao
Ngoài phạm vi
- Service ghi log và phân tích bổ sung
Ràng buộc và giả định
Nêu các giả định
- Traffic không phân bố đồng đều
- Việc tự động cập nhật tài khoản hằng ngày chỉ áp dụng cho user có hoạt động trong 30 ngày gần nhất
- Việc thêm hoặc xoá tài khoản tài chính tương đối hiếm
- Thông báo ngân sách không cần tức thời
- 10 triệu user
- 10 danh mục ngân sách mỗi user = 100 triệu mục ngân sách
- Ví dụ danh mục:
- Nhà ở = $1,000
- Ăn uống = $200
- Xăng = $100
- Người bán (seller) được dùng để xác định danh mục của giao dịch
- 50,000 seller
- 30 triệu tài khoản tài chính
- 5 tỷ giao dịch mỗi tháng
- 500 triệu request đọc mỗi tháng
- Tỷ lệ ghi so với đọc là 10:1
- Nặng về ghi: user phát sinh giao dịch hằng ngày nhưng ít người truy cập site mỗi ngày
Tính toán mức sử dụng
Hỏi người phỏng vấn xem có nên tính toán ước lượng nhanh về mức sử dụng hay không.
- Kích thước mỗi giao dịch:
user_id- 8 bytecreated_at- 5 byteseller- 32 byteamount- 5 byte- Tổng: ~50 byte
- 250 GB nội dung giao dịch mới mỗi tháng
- 50 byte mỗi giao dịch * 5 tỷ giao dịch mỗi tháng
- 9 TB nội dung giao dịch mới trong 3 năm
- Giả định phần lớn là giao dịch mới chứ không phải cập nhật giao dịch cũ
- Trung bình 2,000 giao dịch mỗi giây
- Trung bình 200 request đọc mỗi giây
Bảng quy đổi tiện dụng:
- 2.5 triệu giây mỗi tháng
- 1 request mỗi giây = 2.5 triệu request mỗi tháng
- 40 request mỗi giây = 100 triệu request mỗi tháng
- 400 request mỗi giây = 1 tỷ request mỗi tháng
Bước 2: Tạo thiết kế mức cao
Phác thảo thiết kế mức cao với tất cả các thành phần quan trọng.
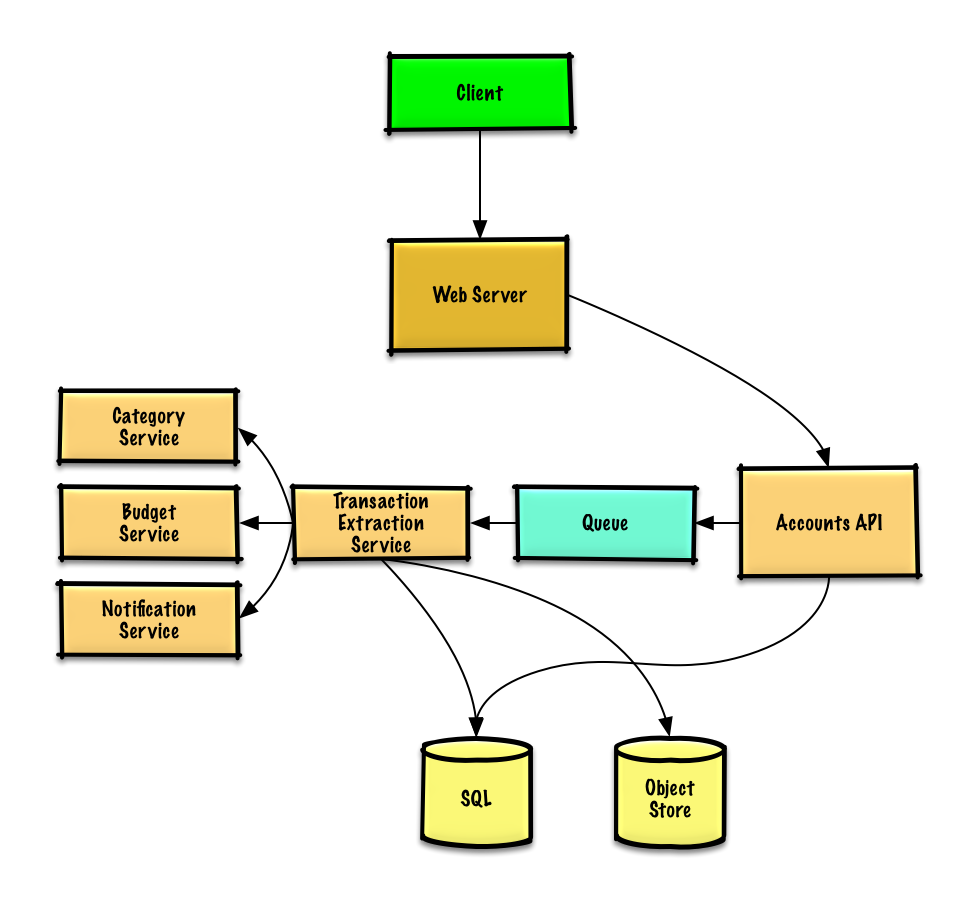
Bước 3: Thiết kế các thành phần cốt lõi
Đi sâu vào chi tiết của từng thành phần cốt lõi.
Use case: User kết nối với một tài khoản tài chính
Chúng ta có thể lưu thông tin của 10 triệu user trong một relational database. Nên thảo luận use case và đánh đổi khi chọn giữa SQL và NoSQL.
- Client gửi request tới Web Server, chạy như một reverse proxy
- Web Server chuyển tiếp request tới server Accounts API
- Server Accounts API cập nhật bảng
accountstrong SQL Database với thông tin tài khoản vừa nhập
Hỏi người phỏng vấn xem bạn được kỳ vọng viết bao nhiêu code.
Bảng accounts có thể có cấu trúc sau:
id int NOT NULL AUTO_INCREMENT
created_at datetime NOT NULL
last_update datetime NOT NULL
account_url varchar(255) NOT NULL
account_login varchar(32) NOT NULL
account_password_hash char(64) NOT NULL
user_id int NOT NULL
PRIMARY KEY(id)
FOREIGN KEY(user_id) REFERENCES users(id)
Chúng ta sẽ tạo index trên id, user_id và created_at để tăng tốc việc tra cứu (thời gian logarit thay vì quét toàn bộ bảng) và giữ dữ liệu trong bộ nhớ. Đọc tuần tự 1 MB từ bộ nhớ mất khoảng 250 microsecond, trong khi đọc từ SSD chậm hơn 4 lần và đọc từ đĩa chậm hơn 80 lần.1
Chúng ta sẽ dùng một REST API công khai:
$ curl -X POST --data '{ "user_id": "foo", "account_url": "bar", \
    "account_login": "baz", "account_password": "qux" }' \
    https://mint.com/api/v1/account
Với giao tiếp nội bộ, có thể dùng Remote Procedure Call.
Tiếp theo, service trích xuất giao dịch từ tài khoản.
Use case: Service trích xuất giao dịch từ tài khoản
Chúng ta cần trích xuất thông tin từ một tài khoản trong các trường hợp sau:
- User liên kết tài khoản lần đầu
- User tự làm mới tài khoản
- Tự động mỗi ngày với những user có hoạt động trong 30 ngày gần nhất
Luồng dữ liệu:
- Client gửi request tới Web Server
- Web Server chuyển tiếp request tới server Accounts API
- Server Accounts API đặt một job vào Queue, ví dụ Amazon SQS hoặc RabbitMQ
- Việc trích xuất giao dịch có thể mất một lúc, nên có lẽ ta muốn xử lý bất đồng bộ bằng queue, dù cách này làm tăng độ phức tạp
- Transaction Extraction Service làm các việc sau:
- Lấy job từ Queue và trích xuất giao dịch của tài khoản đó từ tổ chức tài chính, lưu kết quả dưới dạng file log thô trong Object Store
- Dùng Category Service để phân loại từng giao dịch
- Dùng Budget Service để tính tổng chi tiêu hằng tháng theo danh mục
- Budget Service dùng Notification Service để báo cho user biết khi họ sắp chạm hoặc đã vượt ngân sách
- Cập nhật bảng
transactionstrong SQL Database với các giao dịch đã phân loại - Cập nhật bảng
monthly_spendingtrong SQL Database với tổng chi tiêu hằng tháng theo danh mục - Thông báo cho user biết việc xử lý giao dịch đã hoàn tất thông qua Notification Service:
- Dùng một Queue (không có trong hình) để gửi thông báo bất đồng bộ
Bảng transactions có thể có cấu trúc sau:
id int NOT NULL AUTO_INCREMENT
created_at datetime NOT NULL
seller varchar(32) NOT NULL
amount decimal NOT NULL
user_id int NOT NULL
PRIMARY KEY(id)
FOREIGN KEY(user_id) REFERENCES users(id)
Chúng ta sẽ tạo index trên id, user_id và created_at.
Bảng monthly_spending có thể có cấu trúc sau:
id int NOT NULL AUTO_INCREMENT
month_year date NOT NULL
category varchar(32)
amount decimal NOT NULL
user_id int NOT NULL
PRIMARY KEY(id)
FOREIGN KEY(user_id) REFERENCES users(id)
Chúng ta sẽ tạo index trên id và user_id .
Category service
Với Category Service, ta có thể khởi tạo sẵn một dictionary ánh xạ seller sang danh mục cho những seller phổ biến nhất. Nếu ước tính có 50,000 seller và mỗi entry chiếm dưới 255 byte, dictionary chỉ tốn khoảng 12 MB bộ nhớ.
Hỏi người phỏng vấn xem bạn được kỳ vọng viết bao nhiêu code.
class DefaultCategories(Enum):

    HOUSING = 0
    FOOD = 1
    GAS = 2
    SHOPPING = 3
    ...

seller_category_map = {}
seller_category_map['Exxon'] = DefaultCategories.GAS
seller_category_map['Target'] = DefaultCategories.SHOPPING
...
Với những seller chưa có sẵn trong map, ta có thể dùng cách crowdsourcing bằng cách đánh giá các lần ghi đè danh mục thủ công mà user cung cấp. Ta có thể dùng heap để tra cứu nhanh danh mục được ghi đè nhiều nhất của mỗi seller trong thời gian O(1).
class Categorizer(object):

    def __init__(self, seller_category_map, seller_category_crowd_overrides_map):
        self.seller_category_map = seller_category_map
        self.seller_category_crowd_overrides_map = \
            seller_category_crowd_overrides_map

    def categorize(self, transaction):
        if transaction.seller in self.seller_category_map:
            return self.seller_category_map[transaction.seller]
        elif transaction.seller in self.seller_category_crowd_overrides_map:
            self.seller_category_map[transaction.seller] = \
                self.seller_category_crowd_overrides_map[transaction.seller].peek_min()
            return self.seller_category_map[transaction.seller]
        return None
Cài đặt Transaction:
class Transaction(object):

    def __init__(self, created_at, seller, amount):
        self.created_at = created_at
        self.seller = seller
        self.amount = amount
Use case: Service đề xuất ngân sách
Ban đầu, ta có thể dùng một mẫu ngân sách chung, phân bổ số tiền cho từng danh mục theo bậc thu nhập. Với cách này, ta không cần lưu 100 triệu mục ngân sách đã nêu trong phần ràng buộc, chỉ cần lưu những mục user ghi đè. Nếu user ghi đè một danh mục ngân sách, ta có thể lưu phần ghi đè đó trong TABLE budget_overrides.
class Budget(object):

    def __init__(self, income):
        self.income = income
        self.categories_to_budget_map = self.create_budget_template()

    def create_budget_template(self):
        return {
            DefaultCategories.HOUSING: self.income * .4,
            DefaultCategories.FOOD: self.income * .2,
            DefaultCategories.GAS: self.income * .1,
            DefaultCategories.SHOPPING: self.income * .2,
            ...
        }

    def override_category_budget(self, category, amount):
        self.categories_to_budget_map[category] = amount
Với Budget Service, ta có thể chạy các SQL query trên bảng transactions để tạo bảng tổng hợp monthly_spending. Bảng monthly_spending nhiều khả năng có ít dòng hơn nhiều so với tổng 5 tỷ giao dịch, vì mỗi user thường có nhiều giao dịch trong tháng.
Một phương án khác là chạy các job MapReduce trên các file giao dịch thô để:
- Phân loại từng giao dịch
- Tạo tổng chi tiêu hằng tháng theo danh mục
Chạy phân tích trên các file giao dịch có thể giảm đáng kể tải cho database.
Ta có thể gọi Budget Service để chạy lại phân tích nếu user cập nhật một danh mục.
Hỏi người phỏng vấn xem bạn được kỳ vọng viết bao nhiêu code.
Định dạng file log mẫu, phân tách bằng tab:
user_id timestamp seller amountCài đặt MapReduce:
class SpendingByCategory(MRJob):

    def __init__(self, categorizer):
        self.categorizer = categorizer
        self.current_year_month = calc_current_year_month()
        ...

    def calc_current_year_month(self):
        """Return the current year and month."""
        ...

    def extract_year_month(self, timestamp):
        """Return the year and month portions of the timestamp."""
        ...

    def handle_budget_notifications(self, key, total):
        """Call notification API if nearing or exceeded budget."""
        ...

    def mapper(self, _, line):
        """Parse each log line, extract and transform relevant lines.

        Argument line will be of the form:

        user_id   timestamp   seller  amount

        Using the categorizer to convert seller to category,
        emit key value pairs of the form:

        (user_id, 2016-01, shopping), 25
        (user_id, 2016-01, shopping), 100
        (user_id, 2016-01, gas), 50
        """
        user_id, timestamp, seller, amount = line.split('\t')
        category = self.categorizer.categorize(seller)
        period = self.extract_year_month(timestamp)
        if period == self.current_year_month:
            yield (user_id, period, category), amount

    def reducer(self, key, value):
        """Sum values for each key.

        (user_id, 2016-01, shopping), 125
        (user_id, 2016-01, gas), 50
        """
        total = sum(values)
        yield key, sum(values)
Bước 4: Mở rộng thiết kế
Xác định và xử lý các nút thắt cổ chai, dựa trên các ràng buộc.
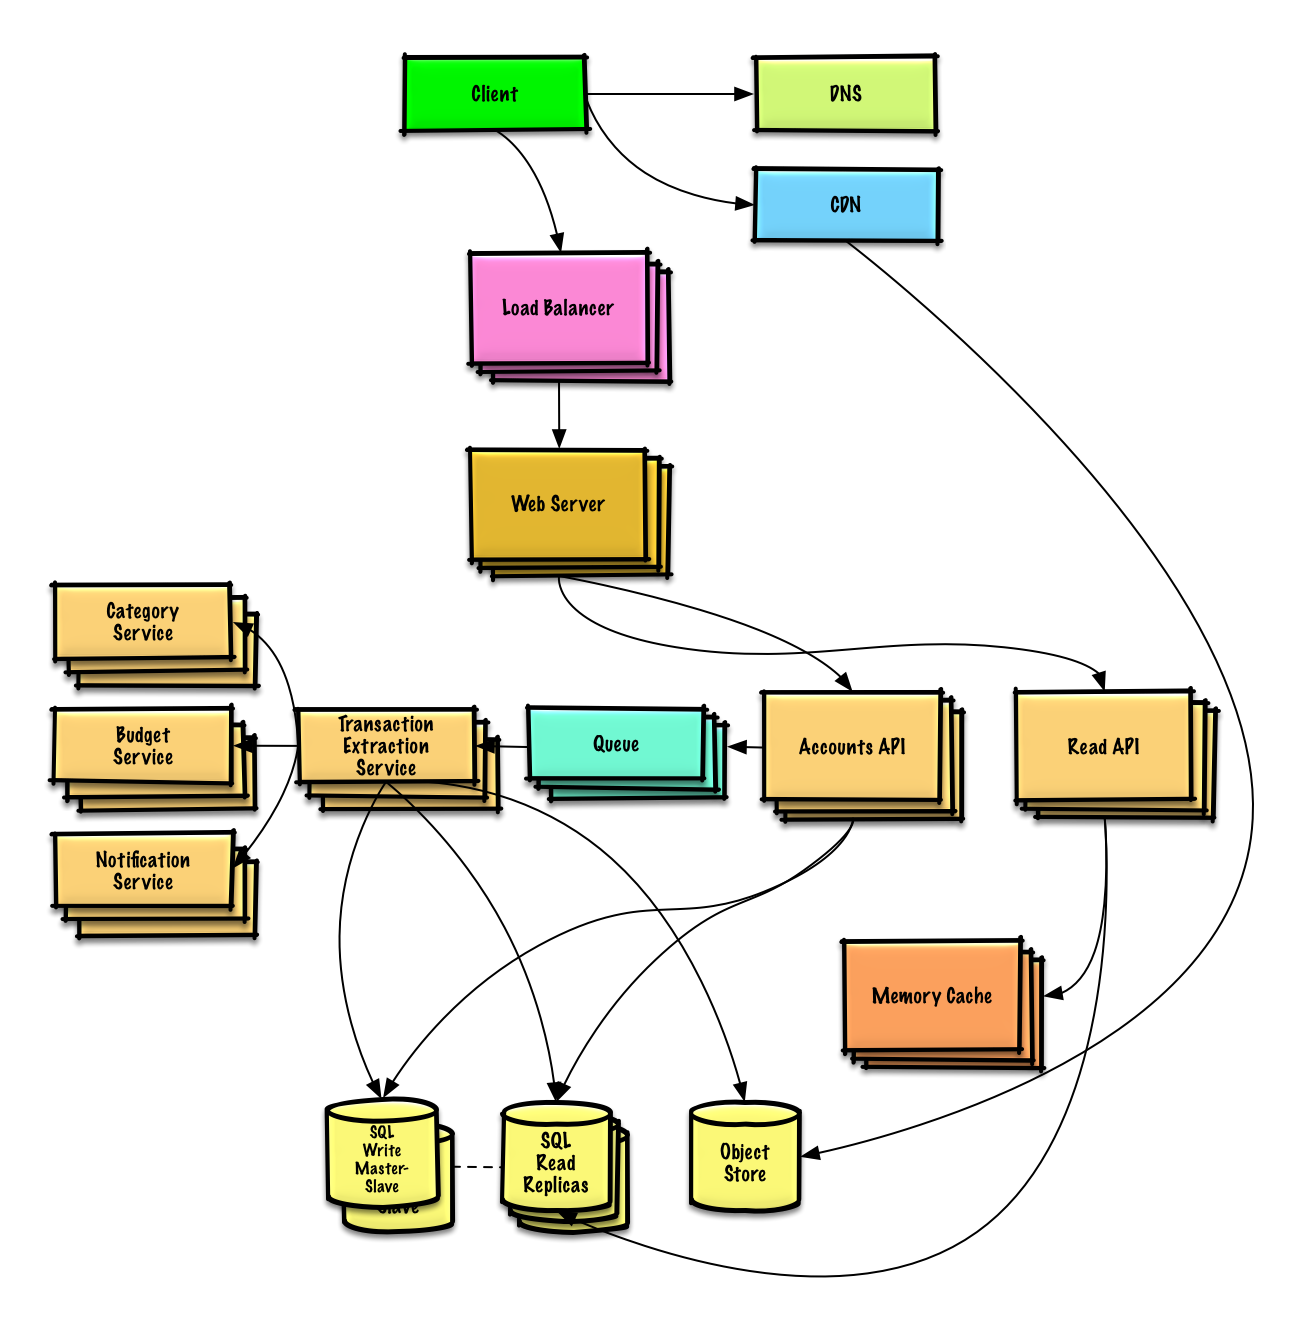
Quan trọng: Đừng nhảy thẳng từ thiết kế ban đầu sang thiết kế cuối cùng!
Hãy nêu rõ bạn sẽ 1) Benchmark/Load Test, 2) Profile để tìm nút thắt cổ chai, 3) xử lý các nút thắt cổ chai đó trong khi cân nhắc các phương án thay thế và đánh đổi, rồi 4) lặp lại. Xem Design a system that scales to millions of users on AWS như một ví dụ về cách mở rộng thiết kế ban đầu theo từng bước.
Điều quan trọng là thảo luận những nút thắt cổ chai bạn có thể gặp với thiết kế ban đầu và cách xử lý từng cái. Ví dụ, việc thêm Load Balancer cùng nhiều Web Server giải quyết những vấn đề gì? CDN? Master-Slave Replicas? Mỗi phương án có những lựa chọn thay thế và đánh đổi nào?
Chúng ta sẽ đưa thêm một số thành phần để hoàn thiện thiết kế và giải quyết các vấn đề về khả năng mở rộng. Các load balancer nội bộ không được vẽ để hình đỡ rối.
Để tránh lặp lại nội dung thảo luận, xem các chủ đề system design sau để biết các ý thảo luận chính, đánh đổi và phương án thay thế:
- DNS
- CDN
- Load balancer
- Horizontal scaling
- Web server (reverse proxy)
- API server (application layer)
- Cache
- Relational database management system (RDBMS)
- SQL write master-slave failover
- Master-slave replication
- Xử lý bất đồng bộ
- Các mẫu nhất quán
- Các mẫu sẵn sàng
Chúng ta bổ sung một use case: User xem các bản tổng hợp và giao dịch.
Session của user, thống kê tổng hợp theo danh mục và các giao dịch gần đây có thể đặt trong Memory Cache như Redis hoặc Memcached.
- Client gửi request đọc tới Web Server
- Web Server chuyển tiếp request tới server Read API
- Nội dung tĩnh có thể được phục vụ từ Object Store như S3, và được cache trên CDN
- Server Read API làm các việc sau:
- Kiểm tra nội dung trong Memory Cache
- Nếu url có trong Memory Cache, trả về nội dung đã cache
- Nếu không
- Nếu url có trong SQL Database, lấy nội dung ra
- Cập nhật Memory Cache với nội dung đó
- Nếu url có trong SQL Database, lấy nội dung ra
- Kiểm tra nội dung trong Memory Cache
Xem Khi nào cập nhật cache để biết các đánh đổi và phương án thay thế. Cách làm ở trên mô tả cache-aside.
Thay vì giữ bảng tổng hợp monthly_spending trong SQL Database, ta có thể tạo một Analytics Database riêng, dùng giải pháp data warehouse như Amazon Redshift hoặc Google BigQuery.
Có thể ta chỉ muốn giữ dữ liệu transactions của một tháng trong database, còn phần còn lại lưu trong data warehouse hoặc Object Store. Một Object Store như Amazon S3 xử lý thoải mái ràng buộc 250 GB nội dung mới mỗi tháng.
Để đáp ứng trung bình 200 request đọc mỗi giây (cao hơn vào giờ cao điểm), traffic của nội dung phổ biến nên do Memory Cache xử lý thay vì database. Memory Cache cũng hữu ích để xử lý traffic phân bố không đều và các đợt tăng đột biến. SQL Read Replicas có thể xử lý các lần cache miss, miễn là các replica không bị quá tải vì phải sao chép các thao tác ghi.
Trung bình 2,000 giao dịch ghi mỗi giây (cao hơn vào giờ cao điểm) có thể là quá sức với một SQL Write Master-Slave đơn lẻ. Ta có thể cần dùng thêm các mẫu mở rộng SQL:
Ta cũng nên cân nhắc chuyển một phần dữ liệu sang NoSQL Database.
Các ý thảo luận thêm
Các chủ đề bổ sung để đi sâu, tuỳ phạm vi bài toán và thời gian còn lại.
NoSQL
Caching
- Cache ở đâu
- Cache cái gì
- Khi nào cập nhật cache
Xử lý bất đồng bộ và microservices
Giao tiếp
- Thảo luận các đánh đổi:
- Giao tiếp bên ngoài với client: HTTP API theo kiểu REST
- Giao tiếp nội bộ: RPC
- Service discovery
Bảo mật
Xem phần bảo mật.
Con số latency
Xem Latency numbers every programmer should know.
Liên tục
- Tiếp tục benchmark và giám sát hệ thống để xử lý các nút thắt cổ chai khi chúng xuất hiện
- Mở rộng là một quá trình lặp lại