Database
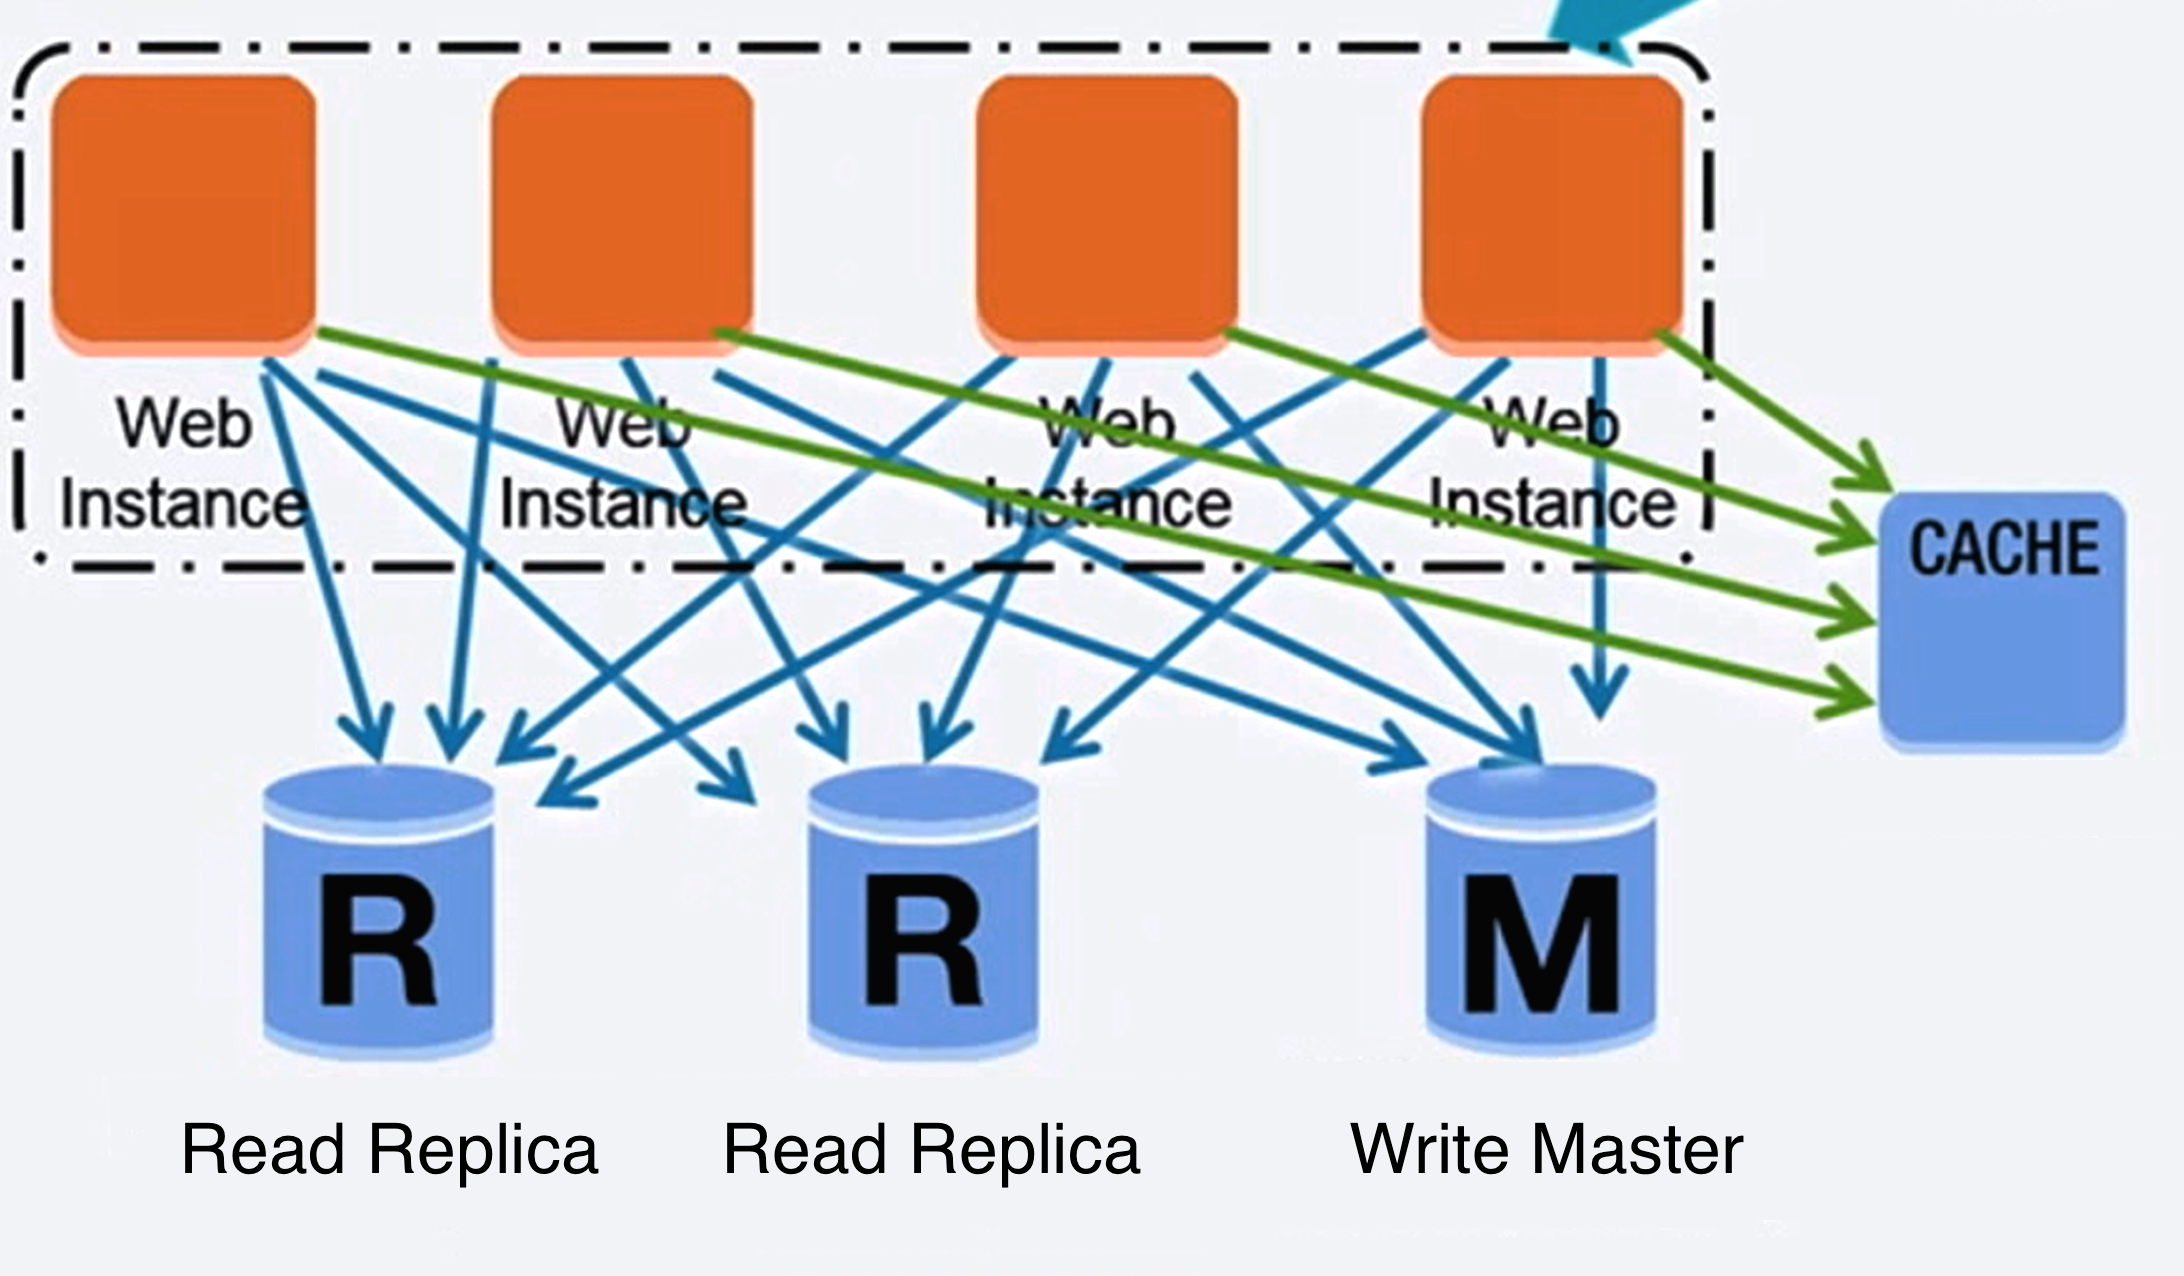
Nguồn: Scaling up to your first 10 million users
Relational database management system (RDBMS)
Relational database như SQL là một tập hợp các mục dữ liệu được tổ chức thành các bảng.
ACID là tập hợp các thuộc tính của transaction trong relational database.
- Atomicity - Mỗi transaction hoặc thực hiện toàn bộ, hoặc không thực hiện gì
- Consistency - Mọi transaction đều đưa database từ một trạng thái hợp lệ sang một trạng thái hợp lệ khác
- Isolation - Thực thi các transaction đồng thời cho kết quả giống như khi thực thi tuần tự từng transaction
- Durability - Một khi transaction đã được commit thì kết quả được giữ vững
Có nhiều kỹ thuật để mở rộng một relational database: master-slave replication, master-master replication, federation, sharding, denormalization và SQL tuning.
Master-slave replication
Master phục vụ cả đọc và ghi, đồng thời replicate các thao tác ghi sang một hoặc nhiều slave, vốn chỉ phục vụ đọc. Slave cũng có thể replicate tiếp sang các slave khác theo dạng cây. Nếu master ngoại tuyến, hệ thống vẫn có thể hoạt động ở chế độ chỉ đọc cho đến khi một slave được nâng lên làm master hoặc một master mới được dựng lên.
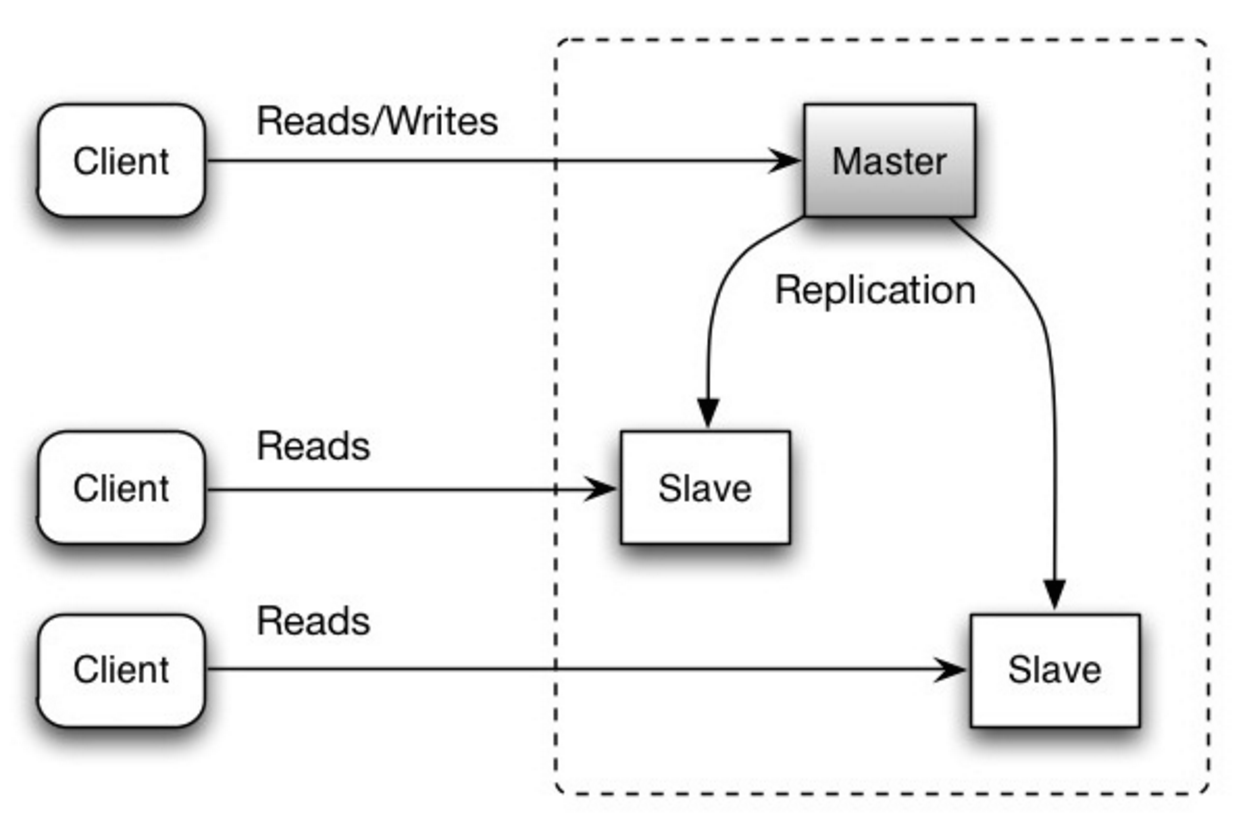
Nguồn: Scalability, availability, stability, patterns
Nhược điểm: master-slave replication
- Cần thêm logic để nâng một slave lên làm master.
- Xem Nhược điểm: replication cho các điểm áp dụng cho cả master-slave và master-master.
Master-master replication
Cả hai master đều phục vụ đọc và ghi, và phối hợp với nhau khi ghi. Nếu một trong hai master ngừng hoạt động, hệ thống vẫn có thể tiếp tục đọc và ghi.
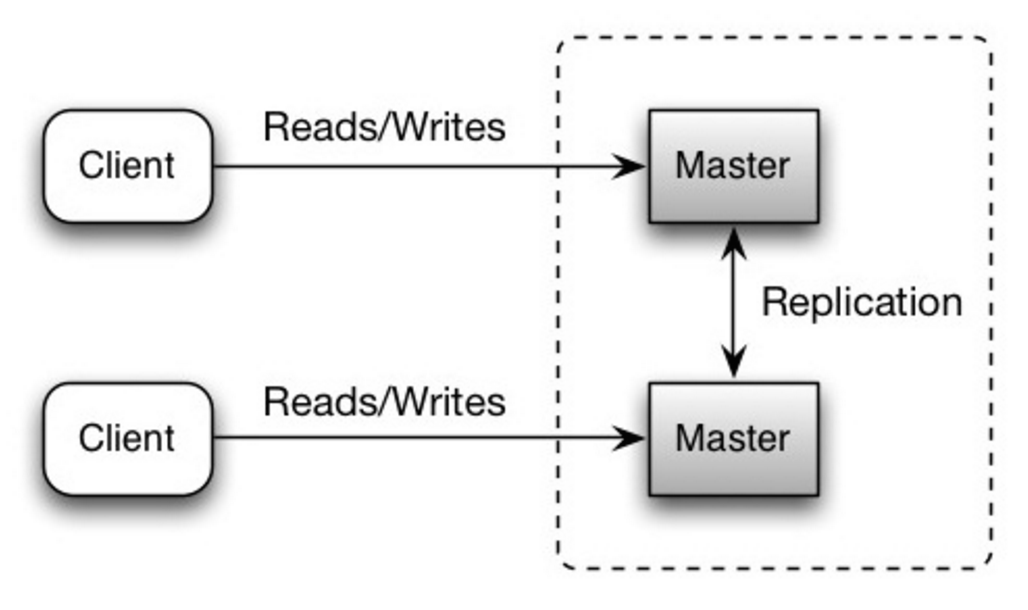
Nguồn: Scalability, availability, stability, patterns
Nhược điểm: master-master replication
- Bạn cần một load balancer, hoặc phải sửa logic ứng dụng để quyết định ghi vào đâu.
- Phần lớn các hệ thống master-master hoặc nhất quán lỏng (vi phạm ACID), hoặc có write latency tăng do phải đồng bộ.
- Việc giải quyết xung đột càng quan trọng khi có thêm nhiều node ghi và khi latency tăng.
- Xem Nhược điểm: replication cho các điểm áp dụng cho cả master-slave và master-master.
Nhược điểm: replication
- Có khả năng mất dữ liệu nếu master gặp sự cố trước khi dữ liệu mới ghi kịp được replicate sang các node khác.
- Các thao tác ghi được phát lại trên các read replica. Nếu có nhiều thao tác ghi, read replica có thể bị quá tải vì phải phát lại và không thực hiện được nhiều lần đọc.
- Càng nhiều slave đọc thì càng phải replicate nhiều, dẫn đến replication lag lớn hơn.
- Ở một số hệ thống, việc ghi vào master có thể sinh nhiều thread để ghi song song, trong khi read replica chỉ hỗ trợ ghi tuần tự bằng một thread.
- Replication làm tăng phần cứng và độ phức tạp.
Nguồn và đọc thêm: replication
Federation
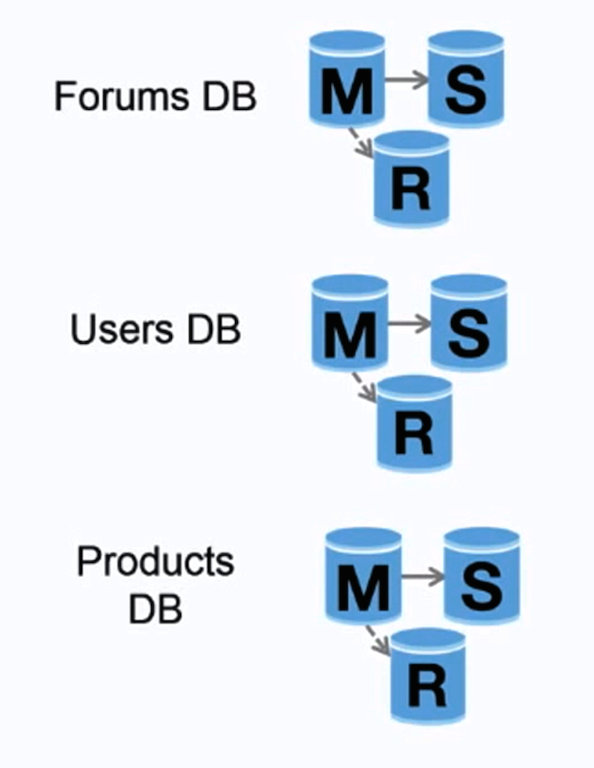
Nguồn: Scaling up to your first 10 million users
Federation (hay functional partitioning) tách database theo chức năng. Ví dụ, thay vì một database nguyên khối duy nhất, bạn có thể có ba database: forums, users và products. Nhờ vậy mỗi database có ít traffic đọc và ghi hơn, và do đó ít replication lag hơn. Database nhỏ hơn thì lượng dữ liệu nằm vừa trong bộ nhớ nhiều hơn, từ đó có nhiều cache hit hơn nhờ cache locality tốt hơn. Khi không có một master trung tâm duy nhất tuần tự hoá các thao tác ghi, bạn có thể ghi song song và tăng throughput.
Nhược điểm: federation
- Federation không hiệu quả nếu schema của bạn có những chức năng hoặc bảng rất lớn.
- Bạn phải cập nhật logic ứng dụng để quyết định đọc và ghi vào database nào.
- Join dữ liệu từ hai database phức tạp hơn khi dùng server link.
- Federation làm tăng phần cứng và độ phức tạp.
Nguồn và đọc thêm: federation
Sharding
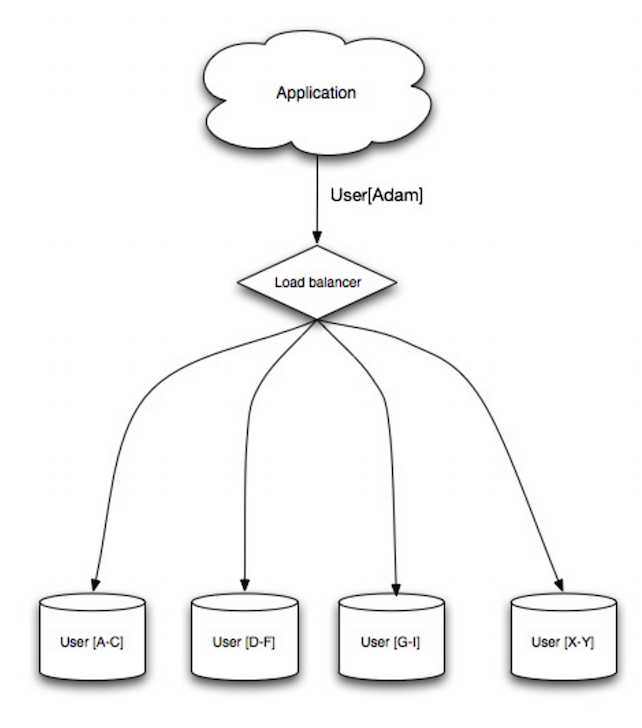
Nguồn: Scalability, availability, stability, patterns
Sharding phân phối dữ liệu qua nhiều database khác nhau sao cho mỗi database chỉ quản lý một tập con của dữ liệu. Lấy database người dùng làm ví dụ, khi số lượng người dùng tăng, cluster được thêm nhiều shard hơn.
Tương tự các ưu điểm của federation, sharding giúp giảm traffic đọc và ghi, giảm replication và tăng cache hit. Kích thước index cũng giảm, thường cải thiện performance nhờ query nhanh hơn. Nếu một shard ngừng hoạt động, các shard còn lại vẫn chạy bình thường, dù bạn nên bổ sung một hình thức replication nào đó để tránh mất dữ liệu. Giống federation, không có master trung tâm duy nhất tuần tự hoá các thao tác ghi, nên bạn có thể ghi song song với throughput cao hơn.
Hai cách phổ biến để shard bảng người dùng là theo chữ cái đầu của họ hoặc theo vị trí địa lý của người dùng.
Nhược điểm: sharding
- Bạn phải cập nhật logic ứng dụng để làm việc với các shard, điều này có thể dẫn đến các SQL query phức tạp.
- Phân bố dữ liệu có thể bị lệch trên một shard. Ví dụ, một nhóm power user nằm trên cùng một shard có thể khiến shard đó chịu tải cao hơn các shard khác.
- Cân bằng lại (rebalancing) làm tăng độ phức tạp. Một hàm sharding dựa trên consistent hashing có thể giảm lượng dữ liệu phải di chuyển.
- Join dữ liệu từ nhiều shard phức tạp hơn.
- Sharding làm tăng phần cứng và độ phức tạp.
Nguồn và đọc thêm: sharding
Denormalization
Denormalization cố gắng cải thiện performance đọc bằng cách đánh đổi một phần performance ghi. Các bản sao dư thừa của dữ liệu được ghi vào nhiều bảng để tránh những join tốn kém. Một số RDBMS như PostgreSQL và Oracle hỗ trợ materialized view, đảm nhận việc lưu thông tin dư thừa và giữ cho các bản sao dư thừa luôn nhất quán.
Khi dữ liệu đã bị phân tán bằng các kỹ thuật như federation và sharding, việc quản lý join giữa các data center càng làm tăng độ phức tạp. Denormalization có thể giúp tránh nhu cầu về những join phức tạp như vậy.
Ở phần lớn hệ thống, số lần đọc có thể nhiều hơn số lần ghi tới 100:1 hoặc thậm chí 1000:1. Một lần đọc phải thực hiện join phức tạp trong database có thể rất tốn kém, mất nhiều thời gian cho các thao tác đĩa.
Nhược điểm: denormalization
- Dữ liệu bị trùng lặp.
- Các ràng buộc có thể giúp các bản sao dư thừa luôn đồng bộ, nhưng làm tăng độ phức tạp của thiết kế database.
- Một database đã denormalize chịu tải ghi nặng có thể chạy kém hơn bản normalize tương ứng.
Nguồn và đọc thêm: denormalization
SQL tuning
SQL tuning là một chủ đề rộng và đã có nhiều cuốn sách được viết làm tài liệu tham khảo.
Điều quan trọng là phải benchmark và profile để mô phỏng và phát hiện các nút thắt cổ chai.
- Benchmark - Mô phỏng các tình huống tải cao bằng những công cụ như ab.
- Profile - Bật các công cụ như slow query log để giúp theo dõi các vấn đề về performance.
Benchmark và profile có thể chỉ ra cho bạn những tối ưu hoá sau.
Siết chặt schema
- MySQL ghi xuống đĩa theo các block liên tục để truy cập nhanh.
- Dùng
CHARthay choVARCHARvới các trường có độ dài cố định.CHARcho phép truy cập ngẫu nhiên nhanh một cách hiệu quả, còn vớiVARCHAR, bạn phải tìm điểm kết thúc của một chuỗi trước khi chuyển sang chuỗi tiếp theo.
- Dùng
TEXTcho các khối văn bản lớn như bài blog.TEXTcũng cho phép tìm kiếm boolean. Dùng trườngTEXTnghĩa là lưu một con trỏ trên đĩa để định vị khối văn bản. - Dùng
INTcho các số lớn hơn, tới 2^32 hay khoảng 4 tỷ. - Dùng
DECIMALcho tiền tệ để tránh lỗi biểu diễn số dấu phẩy động. - Tránh lưu các
BLOBSlớn, hãy lưu vị trí để lấy object đó. VARCHAR(255)là số ký tự lớn nhất có thể đếm bằng một số 8 bit, thường tận dụng tối đa một byte ở một số RDBMS.- Đặt ràng buộc
NOT NULLở những nơi phù hợp để cải thiện performance tìm kiếm.
Dùng index hợp lý
- Các cột bạn truy vấn (
SELECT,GROUP BY,ORDER BY,JOIN) có thể nhanh hơn nhờ index. - Index thường được biểu diễn bằng B-tree tự cân bằng, giữ dữ liệu được sắp xếp và cho phép tìm kiếm, truy cập tuần tự, chèn và xoá trong thời gian logarit.
- Đặt index có thể giữ dữ liệu trong bộ nhớ, đòi hỏi nhiều dung lượng hơn.
- Việc ghi cũng có thể chậm hơn vì index cũng cần được cập nhật.
- Khi nạp một lượng lớn dữ liệu, có thể nhanh hơn nếu tắt index, nạp dữ liệu, rồi dựng lại index.
Tránh các join tốn kém
- Denormalize khi performance đòi hỏi.
Phân vùng bảng
- Tách một bảng bằng cách đặt các điểm nóng vào bảng riêng để giúp giữ chúng trong bộ nhớ.
Tinh chỉnh query cache
- Trong một số trường hợp, query cache có thể dẫn đến vấn đề performance.
Nguồn và đọc thêm: SQL tuning
- Tips for optimizing MySQL queries
- Is there a good reason i see VARCHAR(255) used so often?
- How do null values affect performance?
- Slow query log
NoSQL
NoSQL là tập hợp các mục dữ liệu được biểu diễn dưới dạng key-value store, document store, wide column store hoặc graph database. Dữ liệu được denormalize, và join thường được thực hiện trong code ứng dụng. Phần lớn các NoSQL store không có transaction ACID thực sự và ưu tiên eventual consistency.
BASE thường được dùng để mô tả các thuộc tính của NoSQL database. So với định lý CAP, BASE chọn tính sẵn sàng thay vì tính nhất quán.
- Basically available - hệ thống đảm bảo tính sẵn sàng.
- Soft state - trạng thái của hệ thống có thể thay đổi theo thời gian, ngay cả khi không có đầu vào.
- Eventual consistency - hệ thống sẽ trở nên nhất quán sau một khoảng thời gian, với điều kiện hệ thống không nhận đầu vào trong khoảng thời gian đó.
Ngoài việc chọn giữa SQL hay NoSQL, cũng nên hiểu loại NoSQL database nào phù hợp nhất với use case của bạn. Phần tiếp theo sẽ điểm qua key-value store, document store, wide column store và graph database.
Key-value store
Abstraction: hash table
Key-value store thường cho phép đọc và ghi O(1) và thường được lưu trên bộ nhớ hoặc SSD. Data store có thể giữ các key theo thứ tự từ điển, cho phép truy xuất hiệu quả các dải key. Key-value store có thể cho phép lưu metadata kèm theo một value.
Key-value store có performance cao và thường dùng cho các mô hình dữ liệu đơn giản hoặc dữ liệu thay đổi nhanh, chẳng hạn một lớp cache trong bộ nhớ. Vì chỉ cung cấp một tập thao tác hạn chế, nếu cần thêm thao tác thì độ phức tạp được dồn lên tầng ứng dụng.
Key-value store là nền tảng cho các hệ thống phức tạp hơn như document store, và trong một số trường hợp là graph database.
Nguồn và đọc thêm: key-value store
Document store
Abstraction: key-value store with documents stored as values
Document store xoay quanh các document (XML, JSON, binary, v.v.), trong đó một document lưu toàn bộ thông tin của một object nhất định. Document store cung cấp API hoặc ngôn ngữ query để truy vấn dựa trên cấu trúc bên trong của chính document. Lưu ý, nhiều key-value store có các tính năng làm việc với metadata của value, khiến ranh giới giữa hai loại lưu trữ này bị mờ đi.
Tuỳ theo cách triển khai bên dưới, các document được tổ chức theo collection, tag, metadata hoặc thư mục. Dù các document có thể được tổ chức hoặc gom nhóm với nhau, chúng vẫn có thể có những trường hoàn toàn khác nhau.
Một số document store như MongoDB và CouchDB cũng cung cấp ngôn ngữ giống SQL để thực hiện các query phức tạp. DynamoDB hỗ trợ cả key-value lẫn document.
Document store rất linh hoạt và thường được dùng cho dữ liệu thỉnh thoảng mới thay đổi.
Nguồn và đọc thêm: document store
Wide column store
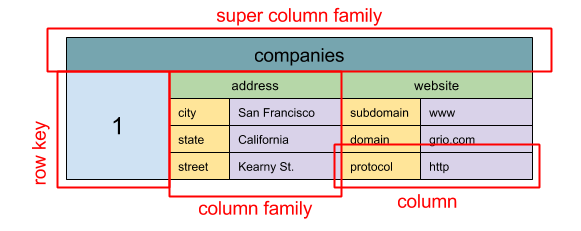
Nguồn: SQL & NoSQL, a brief history
Abstraction: nested map
ColumnFamily<RowKey, Columns<ColKey, Value, Timestamp>>
Đơn vị dữ liệu cơ bản của wide column store là một cột (cặp name/value). Các cột có thể được gom thành column family (tương tự một bảng SQL). Super column family gom thêm các column family lại với nhau. Bạn có thể truy cập từng cột một cách độc lập bằng row key, và các cột có cùng row key tạo thành một hàng. Mỗi value chứa một timestamp để quản lý phiên bản và giải quyết xung đột.
Google giới thiệu Bigtable như wide column store đầu tiên, và nó ảnh hưởng đến HBase mã nguồn mở thường dùng trong hệ sinh thái Hadoop, cũng như Cassandra của Facebook. Các store như BigTable, HBase và Cassandra giữ key theo thứ tự từ điển, cho phép truy xuất hiệu quả các dải key có chọn lọc.
Wide column store có tính sẵn sàng cao và khả năng mở rộng cao. Chúng thường được dùng cho các tập dữ liệu rất lớn.
Nguồn và đọc thêm: wide column store
Graph database
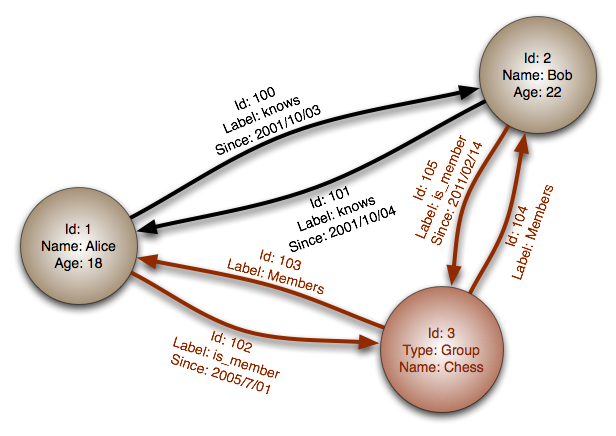

Abstraction: graph
Trong graph database, mỗi node là một bản ghi và mỗi cạnh là một mối quan hệ giữa hai node. Graph database được tối ưu để biểu diễn các mối quan hệ phức tạp với nhiều foreign key hoặc quan hệ many-to-many.
Graph database có performance cao với các mô hình dữ liệu có quan hệ phức tạp, chẳng hạn mạng xã hội. Chúng tương đối mới và chưa được dùng rộng rãi; có thể khó tìm công cụ phát triển và tài nguyên hơn. Nhiều graph chỉ có thể truy cập bằng REST API.
Nguồn và đọc thêm: graph
Nguồn và đọc thêm: NoSQL
- Explanation of base terminology
- NoSQL databases a survey and decision guidance
- Scalability
- Introduction to NoSQL
- NoSQL patterns
SQL hay NoSQL
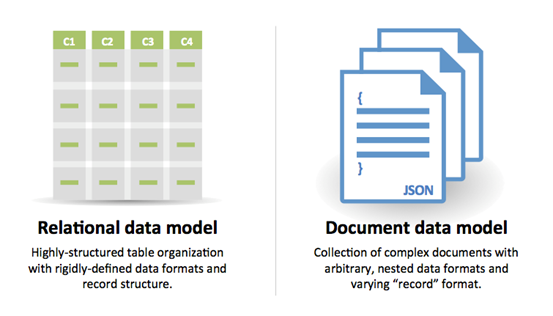
Nguồn: Transitioning from RDBMS to NoSQL
Lý do chọn SQL:
- Dữ liệu có cấu trúc
- Schema chặt chẽ
- Dữ liệu quan hệ
- Cần các join phức tạp
- Transaction
- Có các mẫu mở rộng rõ ràng
- Trưởng thành hơn: developer, cộng đồng, code, công cụ, v.v.
- Tra cứu theo index rất nhanh
Lý do chọn NoSQL:
- Dữ liệu bán cấu trúc
- Schema động hoặc linh hoạt
- Dữ liệu phi quan hệ
- Không cần các join phức tạp
- Lưu trữ nhiều TB (hoặc PB) dữ liệu
- Workload rất nặng về dữ liệu
- Throughput IOPS rất cao
Một số dữ liệu mẫu phù hợp với NoSQL:
- Nạp nhanh dữ liệu clickstream và log
- Dữ liệu bảng xếp hạng hoặc điểm số
- Dữ liệu tạm thời, chẳng hạn giỏ hàng
- Các bảng được truy cập thường xuyên ('hot')
- Bảng metadata/lookup