Thiết kế timeline và tìm kiếm của Twitter
Lưu ý: Tài liệu này liên kết trực tiếp tới các phần liên quan trong các chủ đề system design để tránh lặp lại. Xem nội dung được liên kết để biết các ý thảo luận chung, đánh đổi và phương án thay thế.
Thiết kế feed của Facebook và Thiết kế tìm kiếm của Facebook là các câu hỏi tương tự.
Bước 1: Xác định use case và ràng buộc
Thu thập yêu cầu và giới hạn phạm vi bài toán. Đặt câu hỏi để làm rõ use case và ràng buộc. Thảo luận các giả định.
Vì không có người phỏng vấn để giải đáp các câu hỏi làm rõ, chúng ta sẽ tự định nghĩa một số use case và ràng buộc.
Use case
Chúng ta giới hạn bài toán ở các use case sau
- User đăng một tweet
- Service đẩy tweet tới những người theo dõi, gửi push notification và email
- User xem user timeline (hoạt động của chính user)
- User xem home timeline (hoạt động của những người mà user đang theo dõi)
- User tìm kiếm theo từ khoá
- Service có tính sẵn sàng cao
Ngoài phạm vi
- Service đẩy tweet tới Twitter Firehose và các stream khác
- Service lọc bớt tweet dựa trên cài đặt hiển thị của user
- Ẩn @reply nếu user không đồng thời theo dõi người được trả lời
- Tôn trọng cài đặt 'hide retweets'
- Analytics
Ràng buộc và giả định
Nêu các giả định
Chung
- Traffic không được phân bổ đồng đều
- Đăng một tweet phải nhanh
- Fanout một tweet tới toàn bộ người theo dõi phải nhanh, trừ khi bạn có hàng triệu người theo dõi
- 100 triệu user hoạt động
- 500 triệu tweet mỗi ngày hay 15 tỷ tweet mỗi tháng
- Mỗi tweet trung bình fanout tới 10 nơi nhận
- 5 tỷ tweet được phân phối qua fanout mỗi ngày
- 150 tỷ tweet được phân phối qua fanout mỗi tháng
- 250 tỷ request đọc mỗi tháng
- 10 tỷ lượt tìm kiếm mỗi tháng
Timeline
- Xem timeline phải nhanh
- Twitter nặng về đọc hơn là nặng về ghi
- Tối ưu cho việc đọc tweet nhanh
- Việc nạp tweet nặng về ghi
Tìm kiếm
- Tìm kiếm phải nhanh
- Tìm kiếm nặng về đọc
Tính toán mức sử dụng
Làm rõ với người phỏng vấn xem có nên tính toán ước lượng nhanh về mức sử dụng hay không.
- Kích thước mỗi tweet:
tweet_id- 8 byteuser_id- 32 bytetext- 140 bytemedia- trung bình 10 KB- Tổng: ~10 KB
- 150 TB nội dung tweet mới mỗi tháng
- 10 KB mỗi tweet * 500 triệu tweet mỗi ngày * 30 ngày mỗi tháng
- 5.4 PB nội dung tweet mới trong 3 năm
- 100 nghìn request đọc mỗi giây
- 250 tỷ request đọc mỗi tháng * (400 request mỗi giây / 1 tỷ request mỗi tháng)
- 6,000 tweet mỗi giây
- 15 tỷ tweet mỗi tháng * (400 request mỗi giây / 1 tỷ request mỗi tháng)
- 60 nghìn tweet được phân phối qua fanout mỗi giây
- 150 tỷ tweet được phân phối qua fanout mỗi tháng * (400 request mỗi giây / 1 tỷ request mỗi tháng)
- 4,000 request tìm kiếm mỗi giây
- 10 tỷ lượt tìm kiếm mỗi tháng * (400 request mỗi giây / 1 tỷ request mỗi tháng)
Bảng quy đổi tiện dụng:
- 2.5 triệu giây mỗi tháng
- 1 request mỗi giây = 2.5 triệu request mỗi tháng
- 40 request mỗi giây = 100 triệu request mỗi tháng
- 400 request mỗi giây = 1 tỷ request mỗi tháng
Bước 2: Tạo thiết kế mức cao
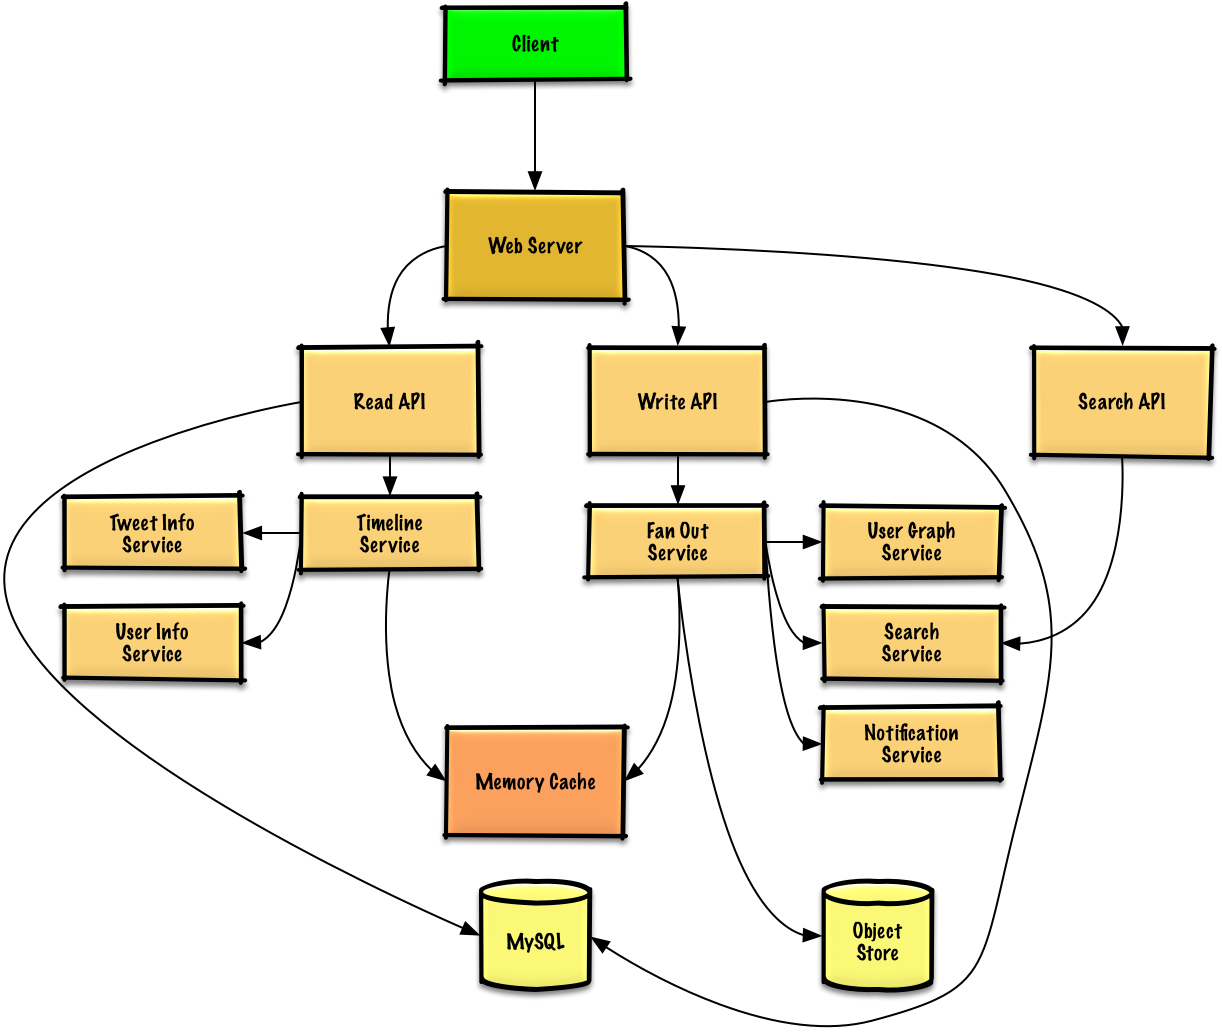
Phác thảo thiết kế mức cao với tất cả các thành phần quan trọng.
Bước 3: Thiết kế các thành phần cốt lõi
Đi sâu vào chi tiết của từng thành phần cốt lõi.
Use case: User đăng một tweet
Chúng ta có thể lưu các tweet của chính user, dùng để tạo user timeline (hoạt động của chính user), trong một relational database. Nên thảo luận về use case và đánh đổi giữa việc chọn SQL hay NoSQL.
Phân phối tweet và dựng home timeline (hoạt động của những người user đang theo dõi) phức tạp hơn. Fanout tweet tới toàn bộ người theo dõi (60 nghìn tweet được phân phối qua fanout mỗi giây) sẽ làm quá tải một relational database truyền thống. Nhiều khả năng chúng ta sẽ muốn chọn một data store ghi nhanh như NoSQL database hoặc Memory Cache. Đọc tuần tự 1 MB từ bộ nhớ mất khoảng 250 microsecond, trong khi đọc từ SSD chậm hơn 4 lần và đọc từ đĩa chậm hơn 80 lần.1
Chúng ta có thể lưu media như ảnh hoặc video trên một Object Store.
- Client đăng một tweet tới Web Server, chạy như một reverse proxy
- Web Server chuyển tiếp request tới Write API server
- Write API lưu tweet vào timeline của user trên một SQL database
- Write API liên hệ Fan Out Service, service này thực hiện các việc sau:
- Truy vấn User Graph Service để tìm những người theo dõi của user, được lưu trong Memory Cache
- Lưu tweet vào home timeline của những người theo dõi user trong một Memory Cache
- Thao tác O(n): 1,000 người theo dõi = 1,000 lần tra cứu và chèn
- Lưu tweet vào Search Index Service để cho phép tìm kiếm nhanh
- Lưu media vào Object Store
- Dùng Notification Service để gửi push notification tới những người theo dõi:
- Dùng một Queue (không vẽ trong sơ đồ) để gửi thông báo bất đồng bộ
Làm rõ với người phỏng vấn xem bạn được kỳ vọng viết bao nhiêu code.
Nếu Memory Cache của chúng ta là Redis, có thể dùng một Redis list gốc với cấu trúc sau:
           tweet n+2                   tweet n+1                   tweet n
| 8 bytes   8 bytes  1 byte | 8 bytes   8 bytes  1 byte | 8 bytes   8 bytes  1 byte |
| tweet_id  user_id  meta   | tweet_id  user_id  meta   | tweet_id  user_id  meta   |
Tweet mới sẽ được đặt vào Memory Cache, nơi tạo nên home timeline của user (hoạt động của những người user đang theo dõi).
Chúng ta sẽ dùng một REST API công khai:
$ curl -X POST --data '{ "user_id": "123", "auth_token": "ABC123", \
    "status": "hello world!", "media_ids": "ABC987" }' \
    https://twitter.com/api/v1/tweet
Response:
{
    "created_at": "Wed Sep 05 00:37:15 +0000 2012",
    "status": "hello world!",
    "tweet_id": "987",
    "user_id": "123",
    ...
}
Với giao tiếp nội bộ, chúng ta có thể dùng Remote Procedure Call.
Use case: User xem home timeline
- Client gửi request lấy home timeline tới Web Server
- Web Server chuyển tiếp request tới Read API server
- Read API server liên hệ Timeline Service, service này thực hiện các việc sau:
- Lấy dữ liệu timeline được lưu trong Memory Cache, gồm các tweet id và user id - O(1)
- Truy vấn Tweet Info Service bằng multiget để lấy thêm thông tin về các tweet id - O(n)
- Truy vấn User Info Service bằng multiget để lấy thêm thông tin về các user id - O(n)
REST API:
$ curl https://twitter.com/api/v1/home_timeline?user_id=123Response:
{
    "user_id": "456",
    "tweet_id": "123",
    "status": "foo"
},
{
    "user_id": "789",
    "tweet_id": "456",
    "status": "bar"
},
{
    "user_id": "789",
    "tweet_id": "579",
    "status": "baz"
},
Use case: User xem user timeline
- Client gửi request lấy user timeline tới Web Server
- Web Server chuyển tiếp request tới Read API server
- Read API lấy user timeline từ SQL Database
REST API sẽ tương tự như của home timeline, chỉ khác là mọi tweet đều đến từ chính user thay vì từ những người user đang theo dõi.
Use case: User tìm kiếm theo từ khoá
- Client gửi request tìm kiếm tới Web Server
- Web Server chuyển tiếp request tới Search API server
- Search API liên hệ Search Service, service này thực hiện các việc sau:
- Phân tích/tách token cho câu truy vấn đầu vào, xác định những gì cần tìm
- Loại bỏ markup
- Tách văn bản thành các term
- Sửa lỗi chính tả
- Chuẩn hoá chữ hoa chữ thường
- Chuyển truy vấn sang dạng dùng các toán tử boolean
- Truy vấn Search Cluster (ví dụ Lucene) để lấy kết quả:
- Scatter gather tới từng server trong cluster để xác định có kết quả nào cho truy vấn hay không
- Gộp, xếp hạng, sắp xếp và trả về kết quả
- Phân tích/tách token cho câu truy vấn đầu vào, xác định những gì cần tìm
REST API:
$ curl https://twitter.com/api/v1/search?query=hello+worldResponse sẽ tương tự như của home timeline, chỉ khác là gồm các tweet khớp với truy vấn đã cho.
Bước 4: Mở rộng thiết kế
Xác định và xử lý các nút thắt cổ chai, dựa trên các ràng buộc đã nêu.
Quan trọng: Đừng nhảy thẳng từ thiết kế ban đầu sang thiết kế cuối cùng!
Hãy nói rõ bạn sẽ 1) Benchmark/Load Test, 2) Profile để tìm nút thắt cổ chai, 3) xử lý các nút thắt cổ chai trong khi cân nhắc các phương án thay thế và đánh đổi, và 4) lặp lại. Xem Design a system that scales to millions of users on AWS làm ví dụ về cách mở rộng thiết kế ban đầu theo từng vòng lặp.
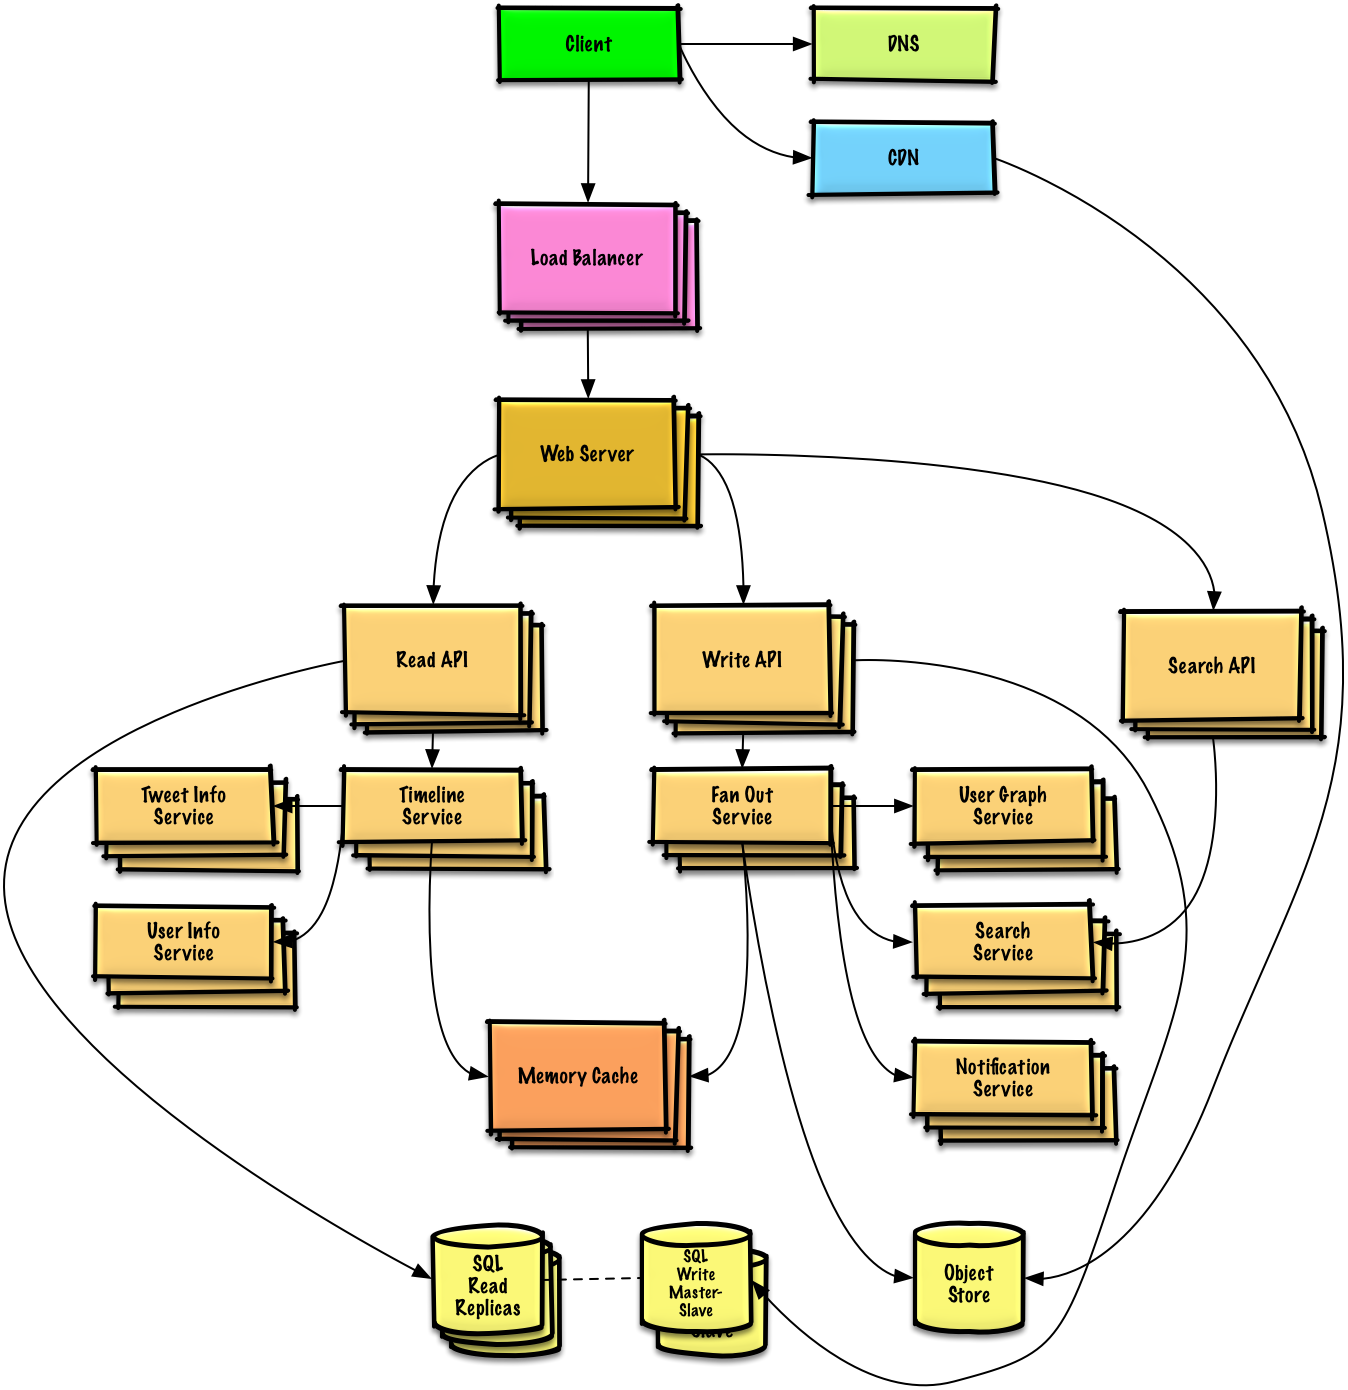
Điều quan trọng là thảo luận những nút thắt cổ chai bạn có thể gặp với thiết kế ban đầu và cách xử lý từng cái. Ví dụ, thêm một Load Balancer với nhiều Web Server giải quyết được những vấn đề gì? CDN? Master-Slave Replicas? Mỗi phương án có những phương án thay thế và đánh đổi nào?
Chúng ta sẽ bổ sung một số thành phần để hoàn thiện thiết kế và xử lý các vấn đề về khả năng mở rộng. Các internal load balancer không được vẽ ra để sơ đồ đỡ rối.
Để tránh lặp lại thảo luận, hãy xem các chủ đề system design sau để biết các ý thảo luận chính, đánh đổi và phương án thay thế:
- DNS
- CDN
- Load balancer
- Horizontal scaling
- Web server (reverse proxy)
- API server (application layer)
- Cache
- Relational database management system (RDBMS)
- SQL write master-slave failover
- Master-slave replication
- Consistency patterns
- Availability patterns
Fanout Service là một nút thắt cổ chai tiềm ẩn. Những user Twitter có hàng triệu người theo dõi có thể mất vài phút để tweet của họ đi hết quá trình fanout. Điều này có thể dẫn tới race condition với các @reply cho tweet đó, và chúng ta có thể giảm thiểu bằng cách sắp xếp lại thứ tự tweet tại thời điểm phục vụ.
Chúng ta cũng có thể tránh fanout tweet của những user có nhiều người theo dõi. Thay vào đó, ta có thể tìm kiếm để lấy tweet của các user này, gộp kết quả tìm kiếm với kết quả home timeline của user, rồi sắp xếp lại thứ tự tweet tại thời điểm phục vụ.
Các tối ưu bổ sung gồm:
- Chỉ giữ vài trăm tweet cho mỗi home timeline trong Memory Cache
- Chỉ giữ thông tin home timeline của các user đang hoạt động trong Memory Cache
- Nếu một user không hoạt động trong 30 ngày qua, chúng ta có thể dựng lại timeline từ SQL Database
- Truy vấn User Graph Service để xác định user đang theo dõi những ai
- Lấy các tweet từ SQL Database và thêm chúng vào Memory Cache
- Nếu một user không hoạt động trong 30 ngày qua, chúng ta có thể dựng lại timeline từ SQL Database
- Chỉ lưu tweet của một tháng trong Tweet Info Service
- Chỉ lưu các user đang hoạt động trong User Info Service
- Search Cluster nhiều khả năng cần giữ tweet trong bộ nhớ để giữ latency thấp
Chúng ta cũng cần xử lý nút thắt cổ chai ở SQL Database.
Dù Memory Cache sẽ giảm tải cho database, chỉ riêng SQL Read Replicas khó có thể đủ sức xử lý các cache miss. Nhiều khả năng chúng ta sẽ cần dùng thêm các pattern mở rộng SQL.
Lượng ghi lớn sẽ làm quá tải một SQL Write Master-Slave duy nhất, cũng cho thấy cần thêm các kỹ thuật mở rộng.
Chúng ta cũng nên cân nhắc chuyển một phần dữ liệu sang NoSQL Database.
Các ý thảo luận thêm
Các chủ đề bổ sung có thể đào sâu, tuỳ phạm vi bài toán và thời gian còn lại.
NoSQL
Caching
- Cache ở đâu
- Cache cái gì
- Khi nào cập nhật cache
Xử lý bất đồng bộ và microservices
Giao tiếp
- Thảo luận các đánh đổi:
- Giao tiếp bên ngoài với client - HTTP API theo chuẩn REST
- Giao tiếp nội bộ - RPC
- Service discovery
Bảo mật
Xem phần bảo mật.
Latency numbers
Xem Latency numbers every programmer should know.
Liên tục
- Tiếp tục benchmark và giám sát hệ thống để xử lý các nút thắt cổ chai khi chúng xuất hiện
- Mở rộng là một quá trình lặp