Thiết kế hệ thống mở rộng tới hàng triệu người dùng trên AWS
Lưu ý: Tài liệu này liên kết trực tiếp tới các phần liên quan trong các chủ đề system design để tránh lặp nội dung. Xem nội dung được liên kết để biết các ý thảo luận chung, đánh đổi và phương án thay thế.
Bước 1: Xác định use case và ràng buộc
Thu thập yêu cầu và giới hạn phạm vi bài toán. Đặt câu hỏi để làm rõ use case và ràng buộc. Thảo luận các giả định.
Vì không có người phỏng vấn để trả lời các câu hỏi làm rõ, ta sẽ tự định nghĩa một số use case và ràng buộc.
Use case
Để giải bài toán này, ta đi theo vòng lặp: 1) Benchmark/Load Test, 2) Profile để tìm nút thắt cổ chai, 3) xử lý các nút thắt cổ chai trong khi cân nhắc các phương án thay thế và đánh đổi, rồi 4) lặp lại. Đây là một pattern tốt để phát triển thiết kế cơ bản thành thiết kế có khả năng mở rộng.
Trừ khi bạn có nền tảng về AWS hoặc đang ứng tuyển vào vị trí đòi hỏi kiến thức AWS, các chi tiết riêng của AWS không phải là yêu cầu bắt buộc. Tuy vậy, phần lớn các nguyên lý bàn trong bài tập này có thể áp dụng rộng hơn, ngoài hệ sinh thái AWS.
Ta giới hạn bài toán ở các use case sau
- User gửi một read hoặc write request
- Service xử lý, lưu dữ liệu người dùng, rồi trả kết quả
- Service cần phát triển từ phục vụ một lượng nhỏ người dùng lên hàng triệu người dùng
- Thảo luận các pattern mở rộng chung khi ta phát triển kiến trúc để xử lý lượng lớn người dùng và request
- Service có tính sẵn sàng cao
Ràng buộc và giả định
Nêu các giả định
- Traffic không phân bố đồng đều
- Cần dữ liệu quan hệ
- Mở rộng từ 1 người dùng lên hàng chục triệu người dùng
- Ký hiệu mức tăng người dùng như sau:
- Users+
- Users++
- Users+++
- ...
- 10 triệu người dùng
- 1 tỷ lượt ghi mỗi tháng
- 100 tỷ lượt đọc mỗi tháng
- Tỷ lệ đọc so với ghi là 100:1
- 1 KB nội dung mỗi lượt ghi
- Ký hiệu mức tăng người dùng như sau:
Tính toán mức sử dụng
Làm rõ với người phỏng vấn xem có cần tính nhẩm mức sử dụng hay không.
- 1 TB nội dung mới mỗi tháng
- 1 KB mỗi lượt ghi * 1 tỷ lượt ghi mỗi tháng
- 36 TB nội dung mới trong 3 năm
- Giả định phần lớn lượt ghi là nội dung mới chứ không phải cập nhật nội dung có sẵn
- Trung bình 400 lượt ghi mỗi giây
- Trung bình 40.000 lượt đọc mỗi giây
Bảng quy đổi tiện dụng:
- 2,5 triệu giây mỗi tháng
- 1 request mỗi giây = 2,5 triệu request mỗi tháng
- 40 request mỗi giây = 100 triệu request mỗi tháng
- 400 request mỗi giây = 1 tỷ request mỗi tháng
Bước 2: Tạo thiết kế mức cao
Phác thảo thiết kế mức cao với tất cả các thành phần quan trọng.
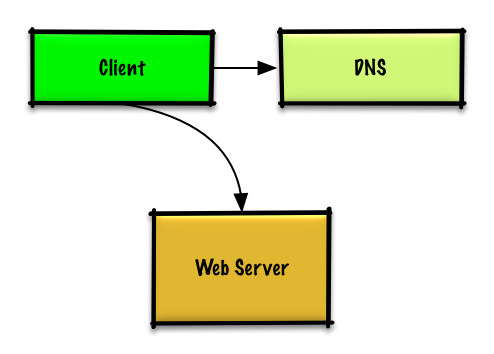
Bước 3: Thiết kế các thành phần cốt lõi
Đi sâu vào chi tiết của từng thành phần cốt lõi.
Use case: User gửi một read hoặc write request
Mục tiêu
- Với chỉ 1-2 người dùng, bạn chỉ cần một cấu hình cơ bản
- Một máy duy nhất cho đơn giản
- Vertical scaling khi cần
- Giám sát để xác định nút thắt cổ chai
Bắt đầu với một máy duy nhất
- Web server trên EC2
- Lưu trữ dữ liệu người dùng
- MySQL Database
Dùng Vertical Scaling:
- Đơn giản là chọn một máy lớn hơn
- Theo dõi các metric để quyết định cách scale up
- Dùng giám sát cơ bản để xác định nút thắt cổ chai: CPU, memory, IO, network, v.v.
- CloudWatch, top, nagios, statsd, graphite, v.v.
- Scale theo chiều dọc có thể rất tốn kém
- Không có dự phòng/failover
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Phương án thay thế cho Vertical Scaling là Horizontal scaling
Bắt đầu với SQL, cân nhắc NoSQL
Các ràng buộc giả định có nhu cầu về dữ liệu quan hệ. Ta có thể bắt đầu bằng một MySQL Database trên máy duy nhất đó.
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem phần Relational database management system (RDBMS)
- Thảo luận các lý do để dùng SQL hoặc NoSQL
Gán một IP tĩnh công khai
- Elastic IP cung cấp một endpoint công khai có IP không đổi khi reboot
- Giúp ích cho failover, chỉ cần trỏ domain sang IP mới
Dùng DNS
Thêm một DNS như Route 53 để ánh xạ domain tới IP công khai của instance.
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem phần Domain name system
Bảo mật web server
- Chỉ mở các port cần thiết
- Cho phép web server phản hồi các request đến từ:
- 80 cho HTTP
- 443 cho HTTPS
- 22 cho SSH, chỉ từ các IP nằm trong whitelist
- Ngăn web server tự khởi tạo kết nối đi ra ngoài
- Cho phép web server phản hồi các request đến từ:
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem phần Bảo mật
Bước 4: Mở rộng thiết kế
Xác định và xử lý các nút thắt cổ chai, dựa trên các ràng buộc đã cho.
Users+
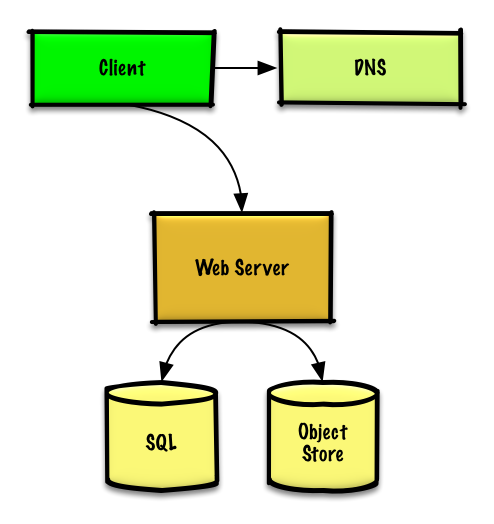
Giả định
Số người dùng bắt đầu tăng và tải trên máy duy nhất của ta ngày càng lớn. Benchmarks/Load Tests và Profiling cho thấy MySQL Database chiếm ngày càng nhiều tài nguyên memory và CPU, trong khi nội dung của người dùng đang lấp đầy dung lượng đĩa.
Cho đến giờ ta xử lý các vấn đề này bằng Vertical Scaling. Tiếc là cách này đã trở nên khá tốn kém và không cho phép scale MySQL Database và Web Server độc lập với nhau.
Mục tiêu
- Giảm tải cho máy duy nhất và cho phép scale độc lập
- Lưu nội dung tĩnh riêng trong một Object Store
- Chuyển MySQL Database sang một máy riêng
- Nhược điểm
- Những thay đổi này làm tăng độ phức tạp và đòi hỏi sửa Web Server để trỏ tới Object Store và MySQL Database
- Phải có thêm các biện pháp bảo mật cho các thành phần mới
- Chi phí AWS cũng có thể tăng, nhưng cần so với chi phí tự quản lý các hệ thống tương tự
Lưu nội dung tĩnh riêng
- Cân nhắc dùng một Object Store được quản lý sẵn như S3 để lưu nội dung tĩnh
- Khả năng mở rộng và độ tin cậy cao
- Mã hóa phía server
- Chuyển nội dung tĩnh sang S3
- File của người dùng
- JS
- CSS
- Ảnh
- Video
Chuyển MySQL database sang một máy riêng
- Cân nhắc dùng một dịch vụ như RDS để quản lý MySQL Database
- Dễ quản trị, dễ scale
- Nhiều availability zone
- Mã hóa khi lưu trữ (encryption at rest)
Bảo mật hệ thống
- Mã hóa dữ liệu khi truyền và khi lưu trữ
- Dùng Virtual Private Cloud
- Tạo một public subnet cho Web Server duy nhất để nó gửi và nhận traffic từ internet
- Tạo một private subnet cho mọi thứ còn lại, ngăn truy cập từ bên ngoài
- Chỉ mở port cho các IP nằm trong whitelist của từng thành phần
- Các pattern này cũng nên được áp dụng cho các thành phần mới trong phần còn lại của bài tập
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem phần Bảo mật
Users++
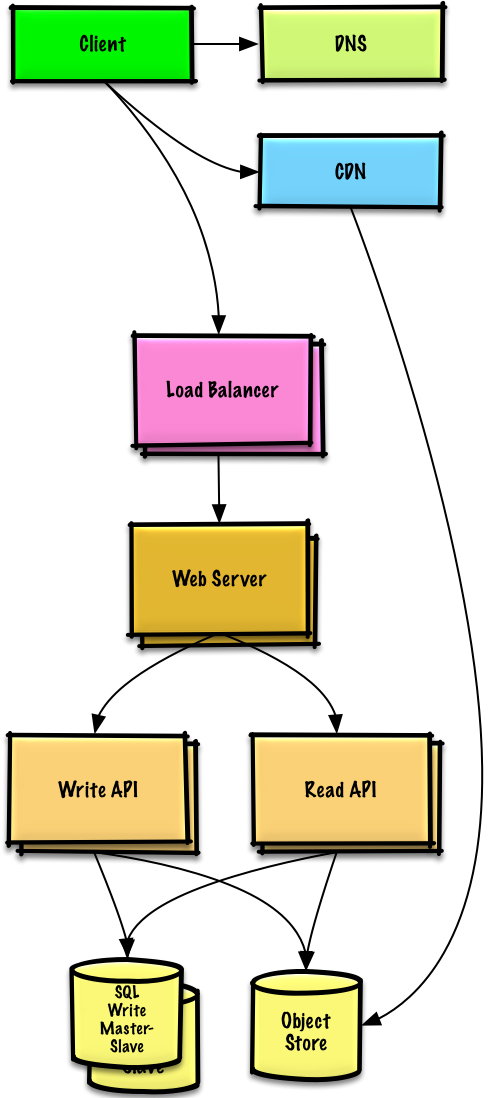
Giả định
Benchmarks/Load Tests và Profiling cho thấy Web Server duy nhất của ta trở thành nút thắt cổ chai vào giờ cao điểm, gây ra phản hồi chậm và đôi khi là downtime. Khi service trưởng thành, ta cũng muốn tiến tới tính sẵn sàng và khả năng dự phòng cao hơn.
Mục tiêu
- Các mục tiêu sau nhằm xử lý vấn đề mở rộng của Web Server
- Dựa trên Benchmarks/Load Tests và Profiling, có thể bạn chỉ cần áp dụng một hoặc hai kỹ thuật trong số này
- Dùng Horizontal Scaling để xử lý tải tăng và loại bỏ các single point of failure
- Thêm một Load Balancer như ELB của Amazon hoặc HAProxy
- ELB có tính sẵn sàng cao
- Nếu tự cấu hình Load Balancer, việc dựng nhiều server theo mô hình active-active hoặc active-passive ở nhiều availability zone sẽ cải thiện tính sẵn sàng
- Kết thúc SSL ngay trên Load Balancer để giảm tải tính toán cho các server phía sau và đơn giản hóa việc quản lý chứng chỉ
- Dùng nhiều Web Server trải đều trên nhiều availability zone
- Dùng nhiều instance MySQL ở chế độ Master-Slave Failover trên nhiều availability zone để tăng khả năng dự phòng
- Thêm một Load Balancer như ELB của Amazon hoặc HAProxy
- Tách Web Server khỏi Application Server
- Scale và cấu hình hai tầng này độc lập với nhau
- Web Server có thể chạy như một Reverse Proxy
- Ví dụ, bạn có thể thêm các Application Server xử lý Read API trong khi các server khác xử lý Write API
- Chuyển nội dung tĩnh (và một phần nội dung động) sang một Content Delivery Network (CDN) như CloudFront để giảm tải và latency
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Users+++
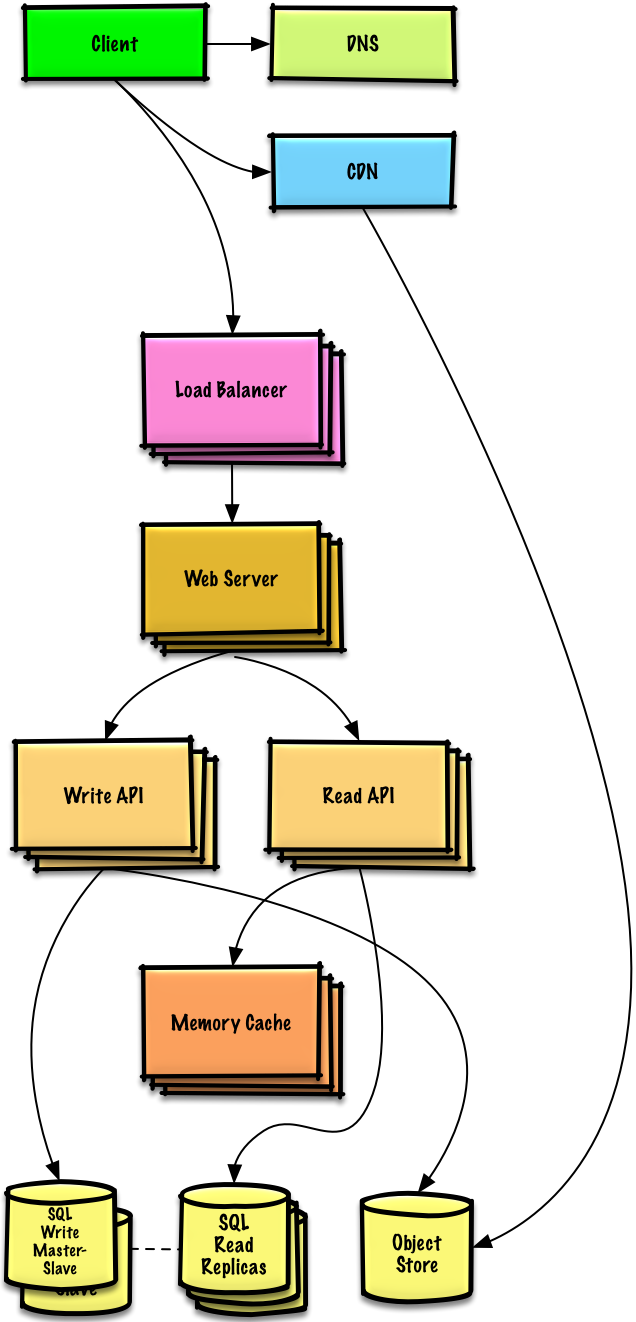
Lưu ý: Internal Load Balancer không được vẽ ra để tránh rối sơ đồ
Giả định
Benchmarks/Load Tests và Profiling cho thấy hệ thống thiên về đọc (100:1 so với ghi) và database đang giảm hiệu năng nghiêm trọng do lượng read request lớn.
Mục tiêu
- Các mục tiêu sau nhằm xử lý vấn đề mở rộng của MySQL Database
- Dựa trên Benchmarks/Load Tests và Profiling, có thể bạn chỉ cần áp dụng một hoặc hai kỹ thuật trong số này
- Chuyển các dữ liệu sau sang một Memory Cache như Elasticache để giảm tải và latency:
- Nội dung được truy cập thường xuyên từ MySQL
- Trước hết, hãy thử cấu hình cache của MySQL Database xem đã đủ để giải tỏa nút thắt cổ chai chưa, rồi mới triển khai Memory Cache
- Dữ liệu session từ các Web Server
- Web Server trở nên stateless, cho phép dùng Autoscaling
- Đọc tuần tự 1 MB từ bộ nhớ mất khoảng 250 microsecond, trong khi đọc từ SSD chậm hơn 4 lần và đọc từ đĩa chậm hơn 80 lần.1
- Nội dung được truy cập thường xuyên từ MySQL
- Thêm MySQL Read Replicas để giảm tải cho write master
- Thêm nhiều Web Server và Application Server để cải thiện khả năng phản hồi
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Thêm MySQL read replicas
- Ngoài việc thêm và scale Memory Cache, MySQL Read Replicas cũng giúp giảm tải cho MySQL Write Master
- Thêm logic vào Web Server để tách riêng lượt ghi và lượt đọc
- Thêm Load Balancer phía trước MySQL Read Replicas (không vẽ ra để tránh rối sơ đồ)
- Phần lớn service thiên về đọc hơn là thiên về ghi
Đánh đổi, phương án thay thế và chi tiết bổ sung:
Users++++
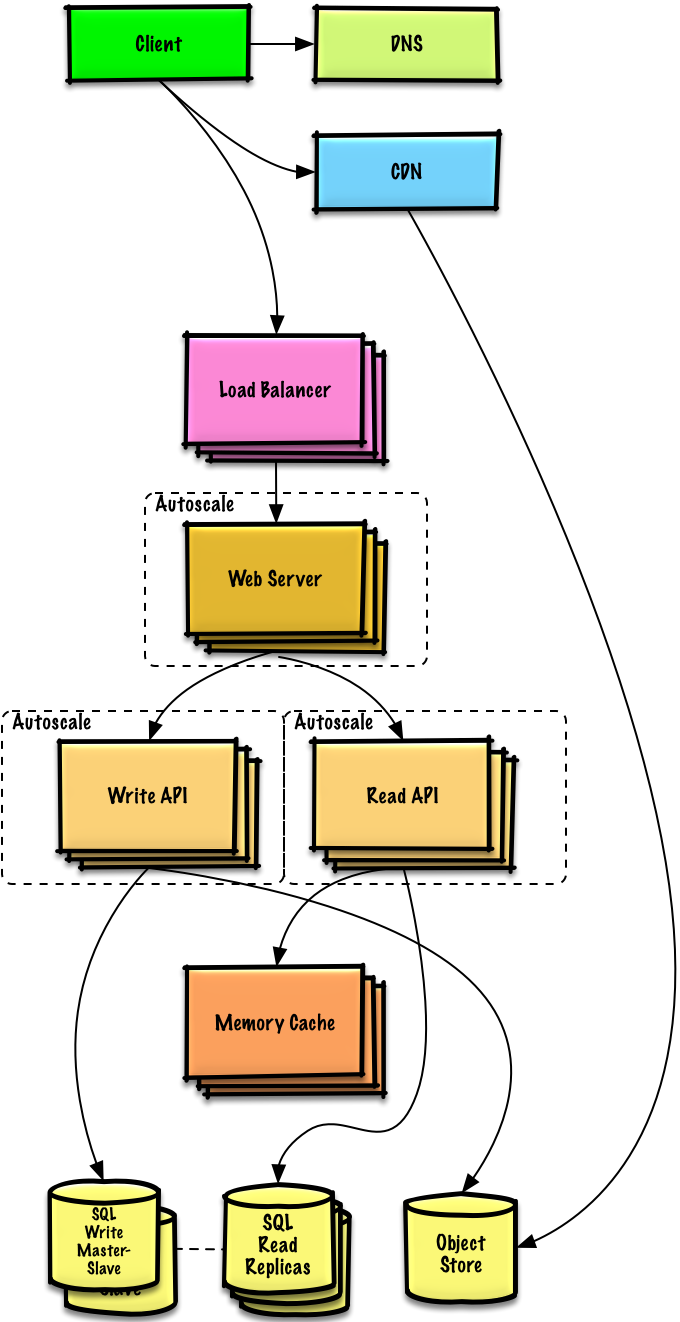
Giả định
Benchmarks/Load Tests và Profiling cho thấy traffic tăng vọt trong giờ làm việc thông thường ở Mỹ và giảm mạnh khi người dùng rời văn phòng. Ta cho rằng có thể cắt giảm chi phí bằng cách tự động bật và tắt server theo tải thực tế. Ta là một đội nhỏ nên muốn tự động hóa càng nhiều DevOps càng tốt, cho Autoscaling và cho vận hành nói chung.
Mục tiêu
- Thêm Autoscaling để cấp phát năng lực khi cần
- Bắt kịp các đợt traffic tăng đột biến
- Giảm chi phí bằng cách tắt các instance không dùng
- Tự động hóa DevOps
- Chef, Puppet, Ansible, v.v.
- Tiếp tục giám sát metric để xử lý các nút thắt cổ chai
- Mức host - Xem xét một EC2 instance riêng lẻ
- Mức tổng hợp - Xem thống kê của load balancer
- Phân tích log - CloudWatch, CloudTrail, Loggly, Splunk, Sumo
- Hiệu năng site nhìn từ bên ngoài - Pingdom hoặc New Relic
- Xử lý thông báo và sự cố - PagerDuty
- Báo cáo lỗi - Sentry
Thêm autoscaling
- Cân nhắc một dịch vụ được quản lý sẵn như AWS Autoscaling
- Tạo một group cho mỗi Web Server và một group cho mỗi loại Application Server, đặt mỗi group trên nhiều availability zone
- Đặt số instance tối thiểu và tối đa
- Dùng trigger để scale up và down thông qua CloudWatch
- Metric đơn giản theo giờ trong ngày cho tải có thể dự đoán, hoặc
- Metric trong một khoảng thời gian:
- Tải CPU
- Latency
- Network traffic
- Metric tùy chỉnh
- Nhược điểm
- Autoscaling có thể làm tăng độ phức tạp
- Hệ thống có thể mất một khoảng thời gian để scale up đủ đáp ứng nhu cầu tăng, hoặc để scale down khi nhu cầu giảm
Users+++++
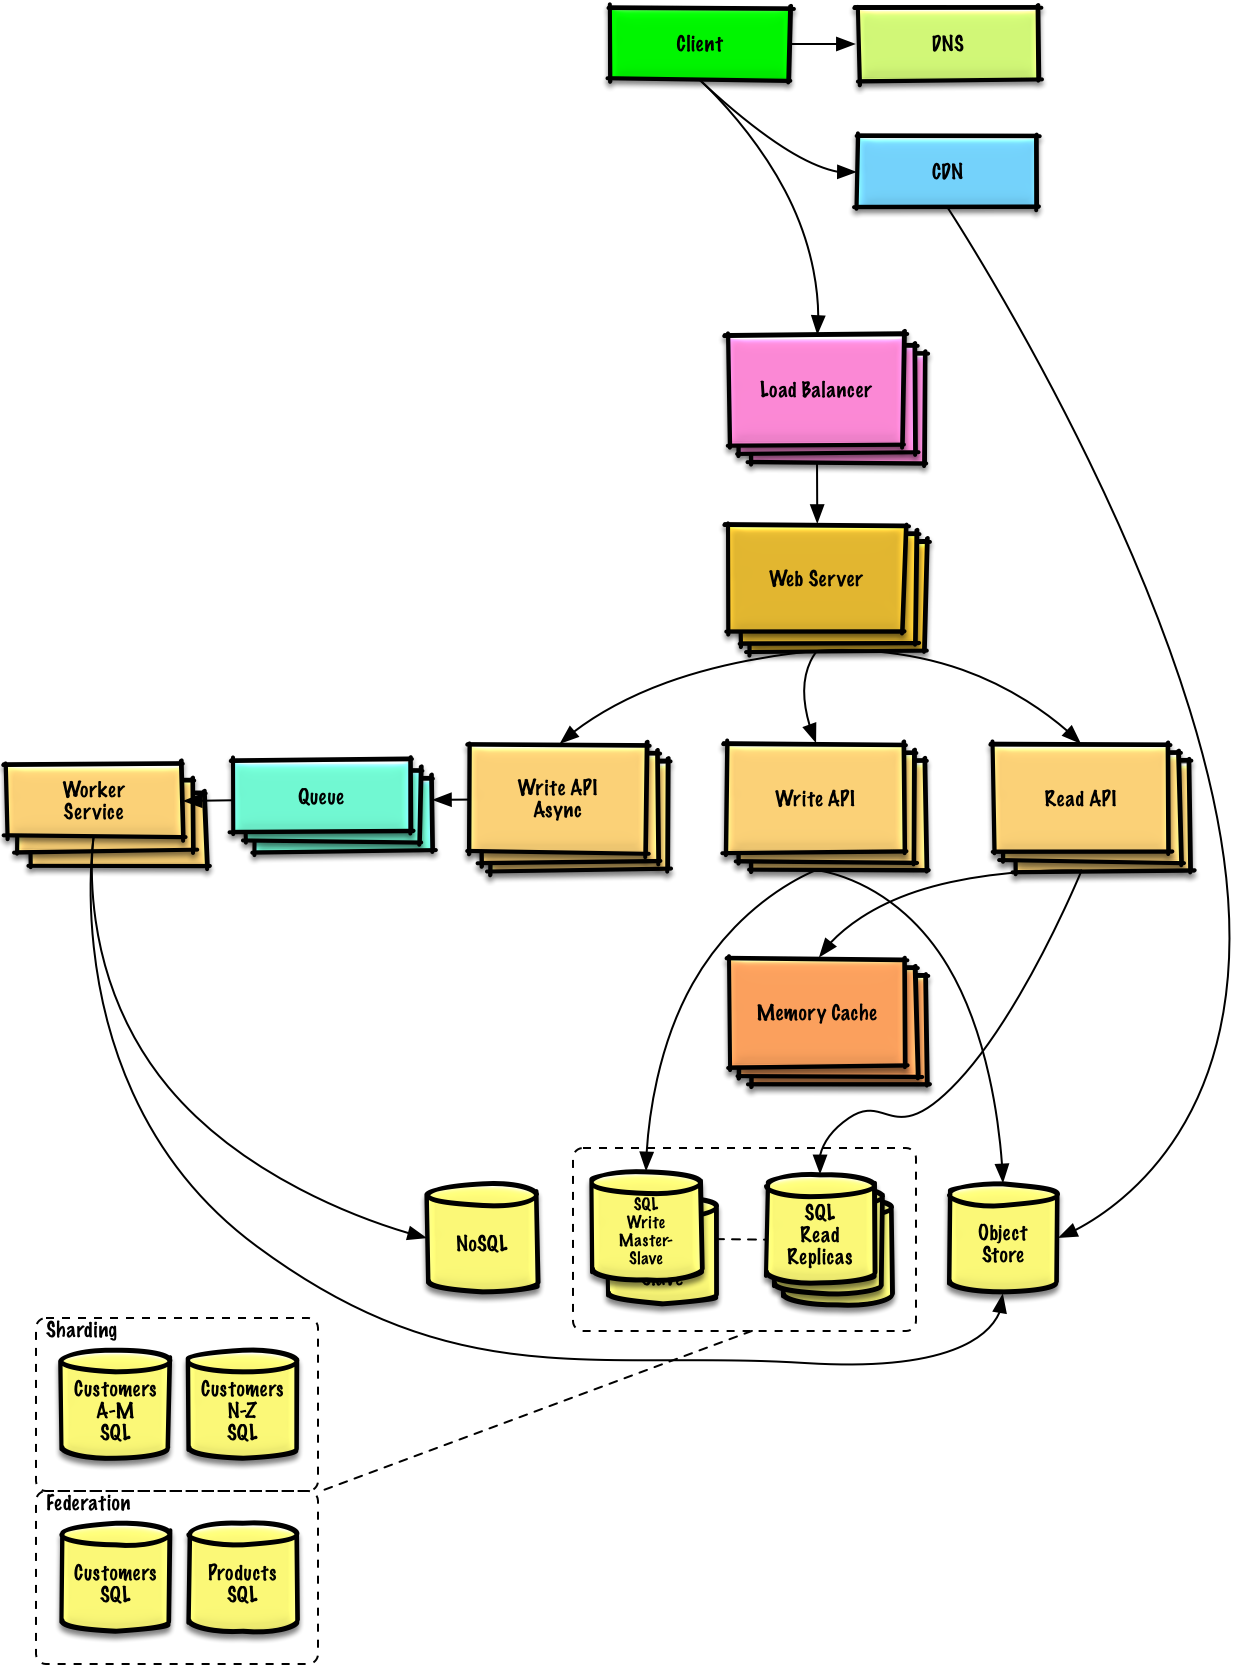
Lưu ý: Các group Autoscaling không được vẽ ra để tránh rối sơ đồ
Giả định
Khi service tiếp tục tăng trưởng tới các con số nêu trong phần ràng buộc, ta lặp đi lặp lại Benchmarks/Load Tests và Profiling để phát hiện và xử lý các nút thắt cổ chai mới.
Mục tiêu
Ta tiếp tục xử lý các vấn đề mở rộng phát sinh từ ràng buộc của bài toán:
- Nếu MySQL Database bắt đầu quá lớn, ta có thể cân nhắc chỉ lưu dữ liệu của một khoảng thời gian giới hạn trong database, còn phần còn lại lưu trong một data warehouse như Redshift
- Một data warehouse như Redshift xử lý thoải mái ràng buộc 1 TB nội dung mới mỗi tháng
- Với trung bình 40.000 read request mỗi giây, read traffic của nội dung phổ biến có thể được xử lý bằng cách scale Memory Cache, thứ cũng hữu ích để xử lý traffic phân bố không đều và các đợt traffic tăng đột biến
- SQL Read Replicas có thể gặp khó khi xử lý các cache miss, nhiều khả năng ta cần dùng thêm các pattern mở rộng SQL
- Trung bình 400 lượt ghi mỗi giây (với đỉnh cao hơn đáng kể) có thể là quá sức với một SQL Write Master-Slave duy nhất, điều này cũng cho thấy cần thêm các kỹ thuật mở rộng khác
Các pattern mở rộng SQL gồm:
Để xử lý thêm lượng read và write request lớn, ta cũng nên cân nhắc chuyển dữ liệu phù hợp sang một NoSQL Database như DynamoDB.
Ta có thể tách riêng thêm các Application Server để scale độc lập. Các batch process hoặc phép tính không cần thực hiện theo thời gian thực có thể được xử lý bất đồng bộ bằng Queue và Worker:
- Ví dụ, trong một service ảnh, việc upload ảnh và việc tạo thumbnail có thể được tách riêng:
- Client upload ảnh
- Application Server đưa một job vào Queue như SQS
- Worker Service trên EC2 hoặc Lambda lấy việc ra khỏi Queue, rồi:
- Tạo thumbnail
- Cập nhật Database
- Lưu thumbnail vào Object Store
Đánh đổi, phương án thay thế và chi tiết bổ sung:
- Xem nội dung được liên kết ở trên để biết chi tiết
Các ý thảo luận thêm
Các chủ đề bổ sung để đào sâu, tùy theo phạm vi bài toán và thời gian còn lại.
Các pattern mở rộng SQL
NoSQL
Caching
- Cache ở đâu
- Cache cái gì
- Khi nào cập nhật cache
Xử lý bất đồng bộ và microservices
Giao tiếp
- Thảo luận các đánh đổi:
- Giao tiếp bên ngoài với client - HTTP API theo REST
- Giao tiếp nội bộ - RPC
- Service discovery
Bảo mật
Xem phần bảo mật.
Các con số về latency
Xem Các con số về latency mà lập trình viên nào cũng nên biết.
Liên tục
- Tiếp tục benchmark và giám sát hệ thống để xử lý các nút thắt cổ chai khi chúng xuất hiện
- Mở rộng là một quá trình lặp